LLM-as-a-Verifier:通用验证框架
中文结构化译文,依据 arXiv
2607.05391v2的 LaTeX 源码逐节整理。 公式、表格与实验数字均回溯至source/main.tex、source/sec/及本地paper.pdf;参考文献题名保留原文。
元信息
- 原题:LLM-as-a-Verifier: A General-Purpose Verification Framework
- arXiv:2607.05391v2
- 版本日期:2026-07-07
- 作者:Jacky Kwok、Shulu Li、Pranav Atreya、Yuejiang Liu、Yixing Jiang、Chelsea Finn、Marco Pavone、Ion Stoica、Azalia Mirhoseini
- 机构:Stanford University;UC Berkeley;NVIDIA Research
- 项目主页:https://llm-as-a-verifier.com
- 代码:https://github.com/llm-as-a-verifier/llm-as-a-verifier
- 本地 PDF:
paper.pdf(31 页) - 英文全文:
main_en.md - LaTeX 源码:
source/main.tex与source/sec/
摘要
扩大预训练、后训练和测试时计算,已经成为提升大语言模型能力的核心范式。本文提出一个新的扩展轴:验证,即判断一个解答是否正确的能力。为了释放这一方向的潜力并验证其有效性,作者提出 LLM-as-a-Verifier:一个无需额外训练、能够为 agent 任务提供细粒度反馈的通用验证框架。
标准 LM judge 通常要求 LLM 为候选解生成一个离散分数;LLM-as-a-Verifier 则对评分 token 的 logits 分布求期望,生成连续分数。这一概率化形式在比较复杂解答时显著降低了平局率,并使验证可以沿三个维度扩展:
- 评分粒度;
- 重复评估;
- 评价标准分解。
实验表明,提高评分粒度能更好地区分正确与错误解,使比较更校准;扩大重复评估次数和分解评价标准,则分别通过降低方差和降低判断复杂度,持续提高验证准确率。
为了让 verification scaling 在实践中可用,作者还提出一种成本较低的排序算法:利用验证器连续分数所导出的偏好概率,在多个候选中选择最佳解。
LLM-as-a-Verifier 跨越代码、机器人和医疗三个领域,在 Terminal-Bench V2、SWE-Bench Verified、RoboRewardBench 和 MedAgentBench 上分别达到 86.5%、78.2%、87.4% 和 73.3%。除候选选择外,细粒度验证信号还能作为任务进度的代理指标。作者为 Claude Code 和 Codex 构建了扩展,帮助开发者监控并改进 agent 系统。最后,论文把验证器分数用作强化学习的密集奖励,在机器人和数学推理任务上提高了 SAC 与 GRPO 的样本效率。
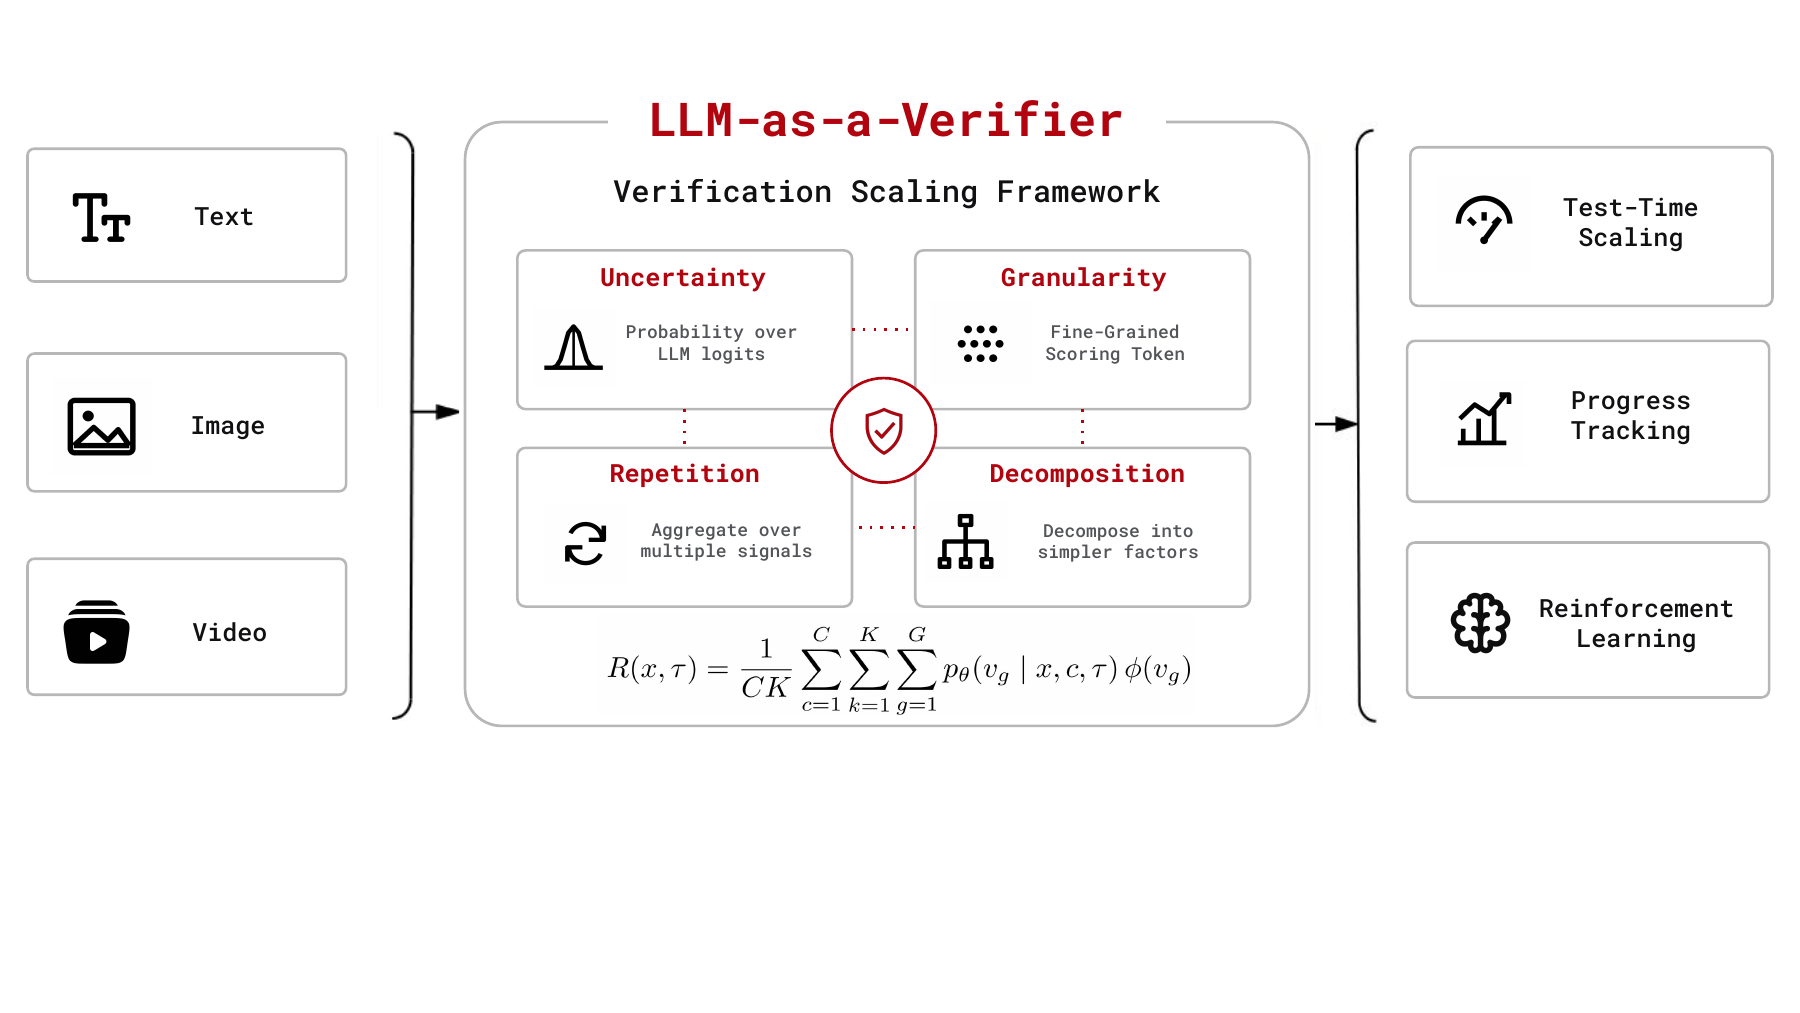
图 2。 同一个框架处理文本、图像和视频输入,通过评分不确定性、评分粒度、重复评估与标准分解产生细粒度信号,并把信号用于测试时扩展、进度跟踪和强化学习。
1 引言
近年来,扩大规模已经成为提升 LLM 能力的核心路径。已有工作分别扩大预训练数据和计算、后训练优化,以及测试时推理计算。然而,生成能力从这些扩展范式中获得了显著收益,验证能力却没有得到同等程度的扩展。
本文把验证定义为判断解答质量或正确性的能力,并主张验证本身是一个独立而尚未充分探索的扩展轴。当前验证系统主要受到两类限制:
- 标准 LM judge 把整个评分分布压缩成粗糙的离散分数,容易产生平局,区分能力不足;
- 训练得到的 reward model 受训练数据约束,跨领域泛化往往不稳定。
LLM-as-a-Verifier 不再只读取模型最终生成的整数分数,而是读取评分 token 的完整概率分布,并对它求期望。这样既保留了模型的不确定性,也把评分从少量整数点扩展成连续信号。
这一概率化形式进一步打开三个扩展维度:
- 提取更多评分 token,提高分数分辨率;
- 对同一个候选重复评估,平均掉单次判断噪声;
- 把复杂的整体标准拆成更简单的子标准,降低 prompt 偏差和判断难度。
对 agent 任务而言,这个细粒度信号可以评价整个交互轨迹,而不只评价某个中间步骤或最终答案。与传统 PRM、ORM 相比,它可以直接覆盖工具调用、代码修改、终端状态、机器人视频和医疗决策轨迹。
作为 trajectory reward model,LLM-as-a-Verifier 在四个基准上达到论文报告的 SOTA:Terminal-Bench V2 86.5%、SWE-Bench Verified 78.2%、RoboRewardBench 轨迹偏好准确率 87.4%、MedAgentBench 73.3%。
细粒度分数还与 agent 的时间进展强相关。在机器人轨迹上,作者报告平均 Value-Order Correlation(VOC)为 0.966。该信号因此不只是排序器,也可以用于监控自治 agent 是否仍在向目标推进。
论文的四项主要贡献是:
- 提出利用评分 token 完整 logits 分布的概率验证框架,并刻画评分粒度、重复评估和标准分解三个扩展轴。
- 提出低成本的候选排序算法;配合 verification scaling,无需额外训练即可在多个领域取得强结果。
- 证明细粒度验证分数与任务进度相关,可用于监控 agent 和机器人。
- 证明验证器可提供 RL 密集反馈,提高机器人和数学推理中 on-policy 与 off-policy 算法的样本效率。
2 预备知识
作者把 agent 与环境的交互建模为有限时域马尔可夫决策过程:
其中:
- \(\mathcal{C}\) 是上下文空间;
- \(\mathcal{S}\) 是状态空间;
- \(\mathcal{A}\) 是动作空间;
- \(P:\mathcal{C}\times\mathcal{S}\times\mathcal{A}\rightarrow\Delta(\mathcal{S})\) 是状态转移;
- \(R:\mathcal{C}\times\mathcal{S}\times\mathcal{A}\rightarrow\mathbb{R}\) 是奖励函数;
- \(H\in\mathbb{N}^{+}\) 是时域长度。
每个 episode 开始时,从上下文空间采样任务提示 \(x\in\mathcal{C}\),agent 从初始状态 \(s_1\in\mathcal{S}\) 出发。在每个时刻 \(t\in[1,H]\),agent 观察状态 \(s_t\),选择动作 \(a_t\),随后按下式转移:
在 LLM agent 中,状态对应此前的交互历史,动作则对应自然语言回复、代码编辑或工具调用等 token 序列。完整轨迹写作:
作者假设有一个参数为 \(\theta\) 的语言模型策略 \(\pi_\theta:\mathcal{C}\times\mathcal{S}\rightarrow\Delta(\mathcal{A})\),动作从中自回归采样。reward model 为动作或轨迹分配标量分数。传统方法要求 LLM 在语言空间生成离散分数,可形式化为:
这里的分数本身就是生成出来的 token,因此只保留被选中的那一个值。
3 提出的方法:LLM-as-a-Verifier
3.1 动机
许多模型其实已经能够解决相当多的任务:同一任务重复执行多次时,候选池中经常至少出现一次正确解。在 Terminal-Bench V2 上,如果假设存在总能选中最佳轨迹的 oracle verifier,并汇集完整 leaderboard 的候选,Oracle Pass@\(K\) 可达到 98.9%。这意味着生成策略已经覆盖了几乎整个 benchmark,真正的瓶颈是能否从候选中识别正确轨迹。
标准 LM judge 可以充当验证器,但它往往只生成一个离散评分 token,再选择概率最高的 token 作为最终分数。这样会把完整评分分布压缩成单点。面对复杂轨迹时,不同候选很容易得到相同分数。论文在 Terminal-Bench 上测得粗粒度评分约有 27% 的平局率。
另一种办法是训练专用 reward model,但它受训练分布限制,跨代码、机器人和医疗领域时未必泛化。作者因此寻找一种无需训练、又能提供细粒度信号的通用方案。
3.2 细粒度奖励估计
作者区分 judge 与 verifier:judge 形成总体意见并作出裁决;verifier 则确认某件事的真实性或正确性,需要更细致的检查。
令评分 token 的有序集合为:
给定任务 \(x\)、验证模型 \(p_\theta\)、评价标准 \(c\),以及两条候选轨迹 \(\tau_i\)、\(\tau_j\),系统用成对 prompt 要求模型分析两条轨迹,并在 <score_A> 与 <score_B> 位置输出 1–20 的评分 token。实现中采用字母化 token 而非直接使用数字,以便稳定提取不同粒度下的 logprob。
与取最大概率 token 不同,LLM-as-a-Verifier 对评分分布求期望。跨 \(C\) 个标准和 \(K\) 次重复验证后,轨迹奖励为:
这里:
- \(C\) 是评价标准数量;
- \(K\) 是重复验证次数;
- \(G\) 是评分 token 数,即评分粒度;
- \(p_\theta(v_g\mid x,c,\tau)\) 是模型给评分 token \(v_g\) 的概率;
- \(\phi(v_g)\) 把评分 token 映射成标量值。
随后用线性映射把 \(R(x,\tau)\) 归一化到 \([0,1]\):
这个连续值保留了模型的评分不确定性。例如,两个候选的最高概率 token 都可能是 15 分,但一个分布集中在 14–16,另一个集中在 12–15;离散 judge 会把它们判成平局,期望分数则能继续区分。
3.3 成对偏好概率
作者把连续奖励视为轨迹的潜在强度,再用 Bradley–Terry 模型转成成对偏好概率:
如果 \(R(x,\tau_i)\) 高于 \(R(x,\tau_j)\),前者胜出的概率就大于 0.5。相比硬性的 win/loss,这种 soft preference 能把不确定性带入候选排序。
3.4 概率枢轴锦标赛
若对 \(N\) 个候选进行完整循环赛,需要比较 \(\binom{N}{2}\) 对,成本为 \(\mathcal{O}(N^2)\)。每次比较后,系统把 soft win mass 累加给两条轨迹:
为减少成本,作者提出 Probabilistic Pivot Tournament(PPT),只让每个候选与一小组 \(k\ll N\) 的枢轴候选比较,把复杂度降为 \(\mathcal{O}(Nk)\)。
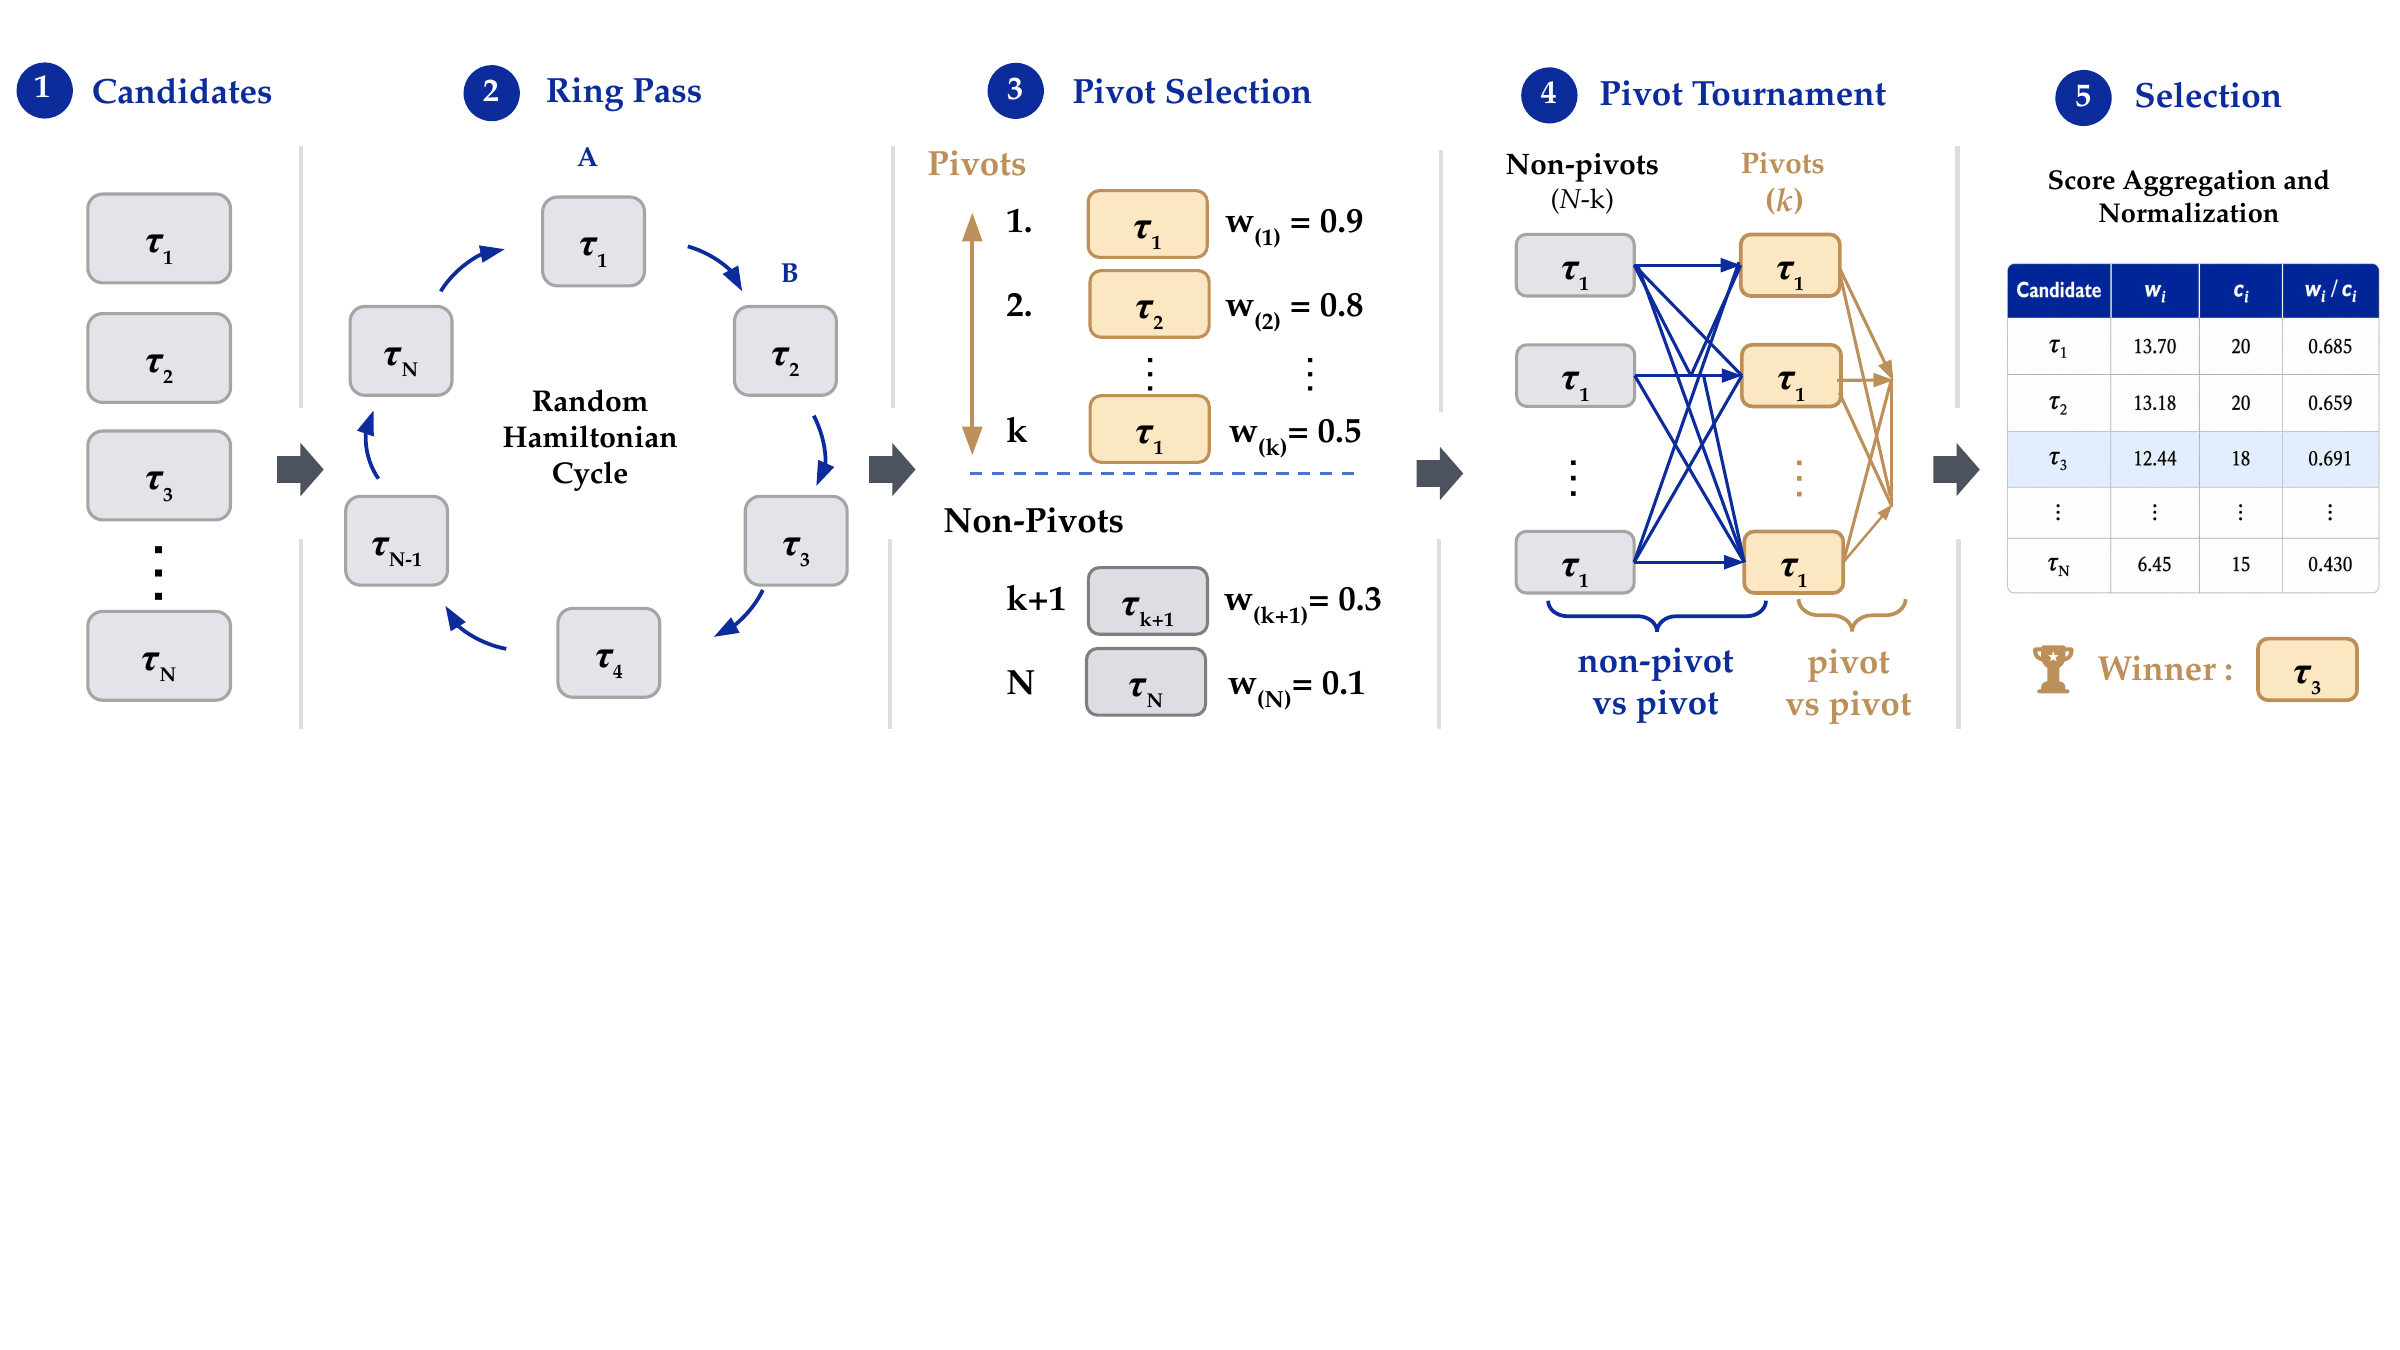
图 6。 PPT 先用环形比较抵消 A/B 位置偏差,再选出经验上最强的 top-\(k\) 候选作为 pivots,把剩余预算集中在可能正确的候选附近。
PPT 分三步:
- 环形初筛。 对 \(\{1,\ldots,N\}\) 采样随机 Hamiltonian cycle \(\gamma\),比较环上 \(N\) 个相邻 pair。每个候选恰好在 prompt 的 A 位置出现一次、B 位置出现一次,因此模型对某个位置的系统偏好在期望上被抵消。
- 选择 pivots。 按环形初筛的平均偏好 \(w_i/c_i\) 排序,取 top-\(k\) 作为枢轴集合 \(\mathcal{P}\)。这样后续预算用于区分最有希望的候选,而非浪费在明显较弱的固定锚点上。
- 枢轴轮次。 比较所有 non-pivot–pivot 组合,并比较所有 pivot–pivot 组合。把这些结果与环形结果共同累加到 \(w_i,c_i\),最终选择 \(w_i/c_i\) 最大者。
除以比较次数 \(c_i\) 很重要,因为 pivots 参与的比较比普通候选更多。总比较数为:
当 \(k\ll N\) 时,它随 \(Nk\) 而非 \(N^2\) 增长。
4 验证扩展
核心奖励公式包含三个彼此独立的扩展轴:评分 token 粒度 \(G\)、重复评估次数 \(K\)、评价标准数量 \(C\)。三者分别处理不同误差来源:
- 提高 \(G\),改善候选分数的分离;
- 提高 \(K\),平均单次验证的噪声;
- 提高并分解 \(C\),捕获轨迹质量的互补方面。
缩放实验统一使用 Gemini 2.5 Flash,因为它允许提取每个评分位置最多 20 个 top logprobs。实验从 Terminal-Bench 的多个 agent harness 随机抽取 200 条轨迹,以正确轨迹是否获得更高分来计算 pairwise verification accuracy。
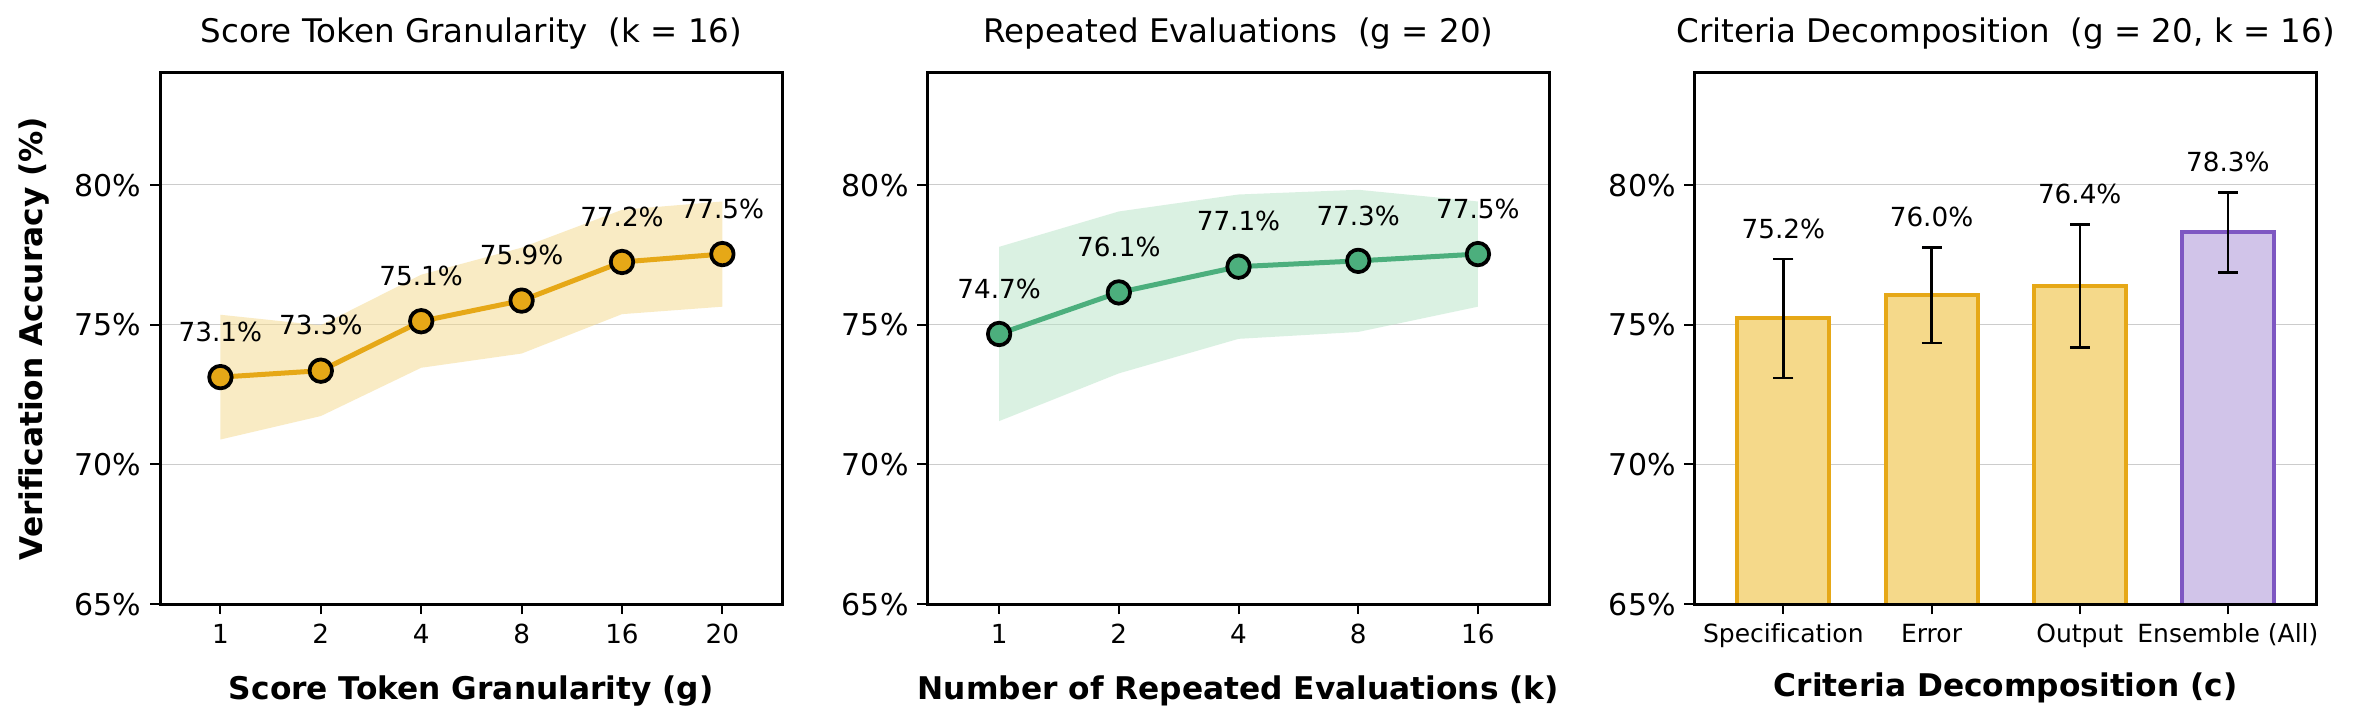
图 4。 准确率随评分粒度、重复次数和标准分解一致上升:\(G=1\rightarrow20\) 时从 73.1% 到 77.5%;\(K=1\rightarrow16\) 时从 74.7% 到约 77.5%;三个标准 ensemble 达到 78.3%。
4.1 评分 token 粒度
标准 LM judge 把评分分布压成概率最高的 token,得到分辨率为 \(1/G\) 的离散奖励。扩大有序评分 token 集合并不会给验证器提供新的轨迹信息,但它给解码器提供了更细的空间,让原本会四舍五入到同一整数的邻近信念映射为不同连续奖励。
作者用正确轨迹分数 \(s_c\) 与错误轨迹分数 \(s_i\) 的差定义信噪比:
分子表示验证器偏好正确轨迹的平均强度,分母表示这种偏好在不同 pair 上有多不稳定。
| 粒度 \(G\) | 1 | 4 | 16 | 20 |
|---|---|---|---|---|
| SNR(\(K=16\)) | 0.775 | 0.786 | 0.797 | 0.799 |
Terminal-Bench 上,SNR 从 \(G=1\) 的 0.775 提升到 \(G=20\) 的 0.799,对应 pairwise accuracy 从 73.1% 提升到 77.5%。
query-optimize 案例
该任务要求 agent 优化一条 SQLite 查询,同时保持输出完全一致。两条候选都让查询运行更快,但验证方法不同:
- 正确轨迹在 canonical database 上等待原查询完整运行约 5 分钟,再直接
diff优化后输出; - 错误轨迹没有在同一数据库上验证等价性,而是复制数据库、添加索引后进行不等价的比较。
Gemini 2.5 Flash 能识别第二种方法的问题,但推理措辞常带有“稍微更干净”“略微更直接”等犹豫语气。离散分数会把这种细微差异压没。
| 方法 | 正确轨迹更高 | 平局 | 错误轨迹更高 |
|---|---|---|---|
| Judge,离散,\(G=5\) | 12/100 | 88/100 | 0/100 |
| Verifier,连续,\(G=5\) | 69/100 | 0/100 | 31/100 |
| Verifier,连续,\(G=20\) | 77/100 | 0/100 | 23/100 |
即使仍使用 5 档评分,只把 argmax 改成分布期望,也能完全消除平局;再把粒度提高到 20,正确排序次数进一步增至 77。
4.2 重复评估
粒度只改善单次 forward pass 的校准,不能消除单次判断的方差。即使 \(G\) 很大,一次评估 \(R^{(k)}(x,\tau)\) 仍可能被 prompt 的偶然特征或验证器对某条轨迹的特殊失败模式影响。
对 \(K\) 次独立评估取平均:
可视为底层期望奖励的 Monte Carlo 估计,其方差按 \(\mathcal{O}(1/K)\) 缩小,偏差不变。提高粒度让单个估计器更敏锐;重复评估则平均掉前者无法移除的噪声。
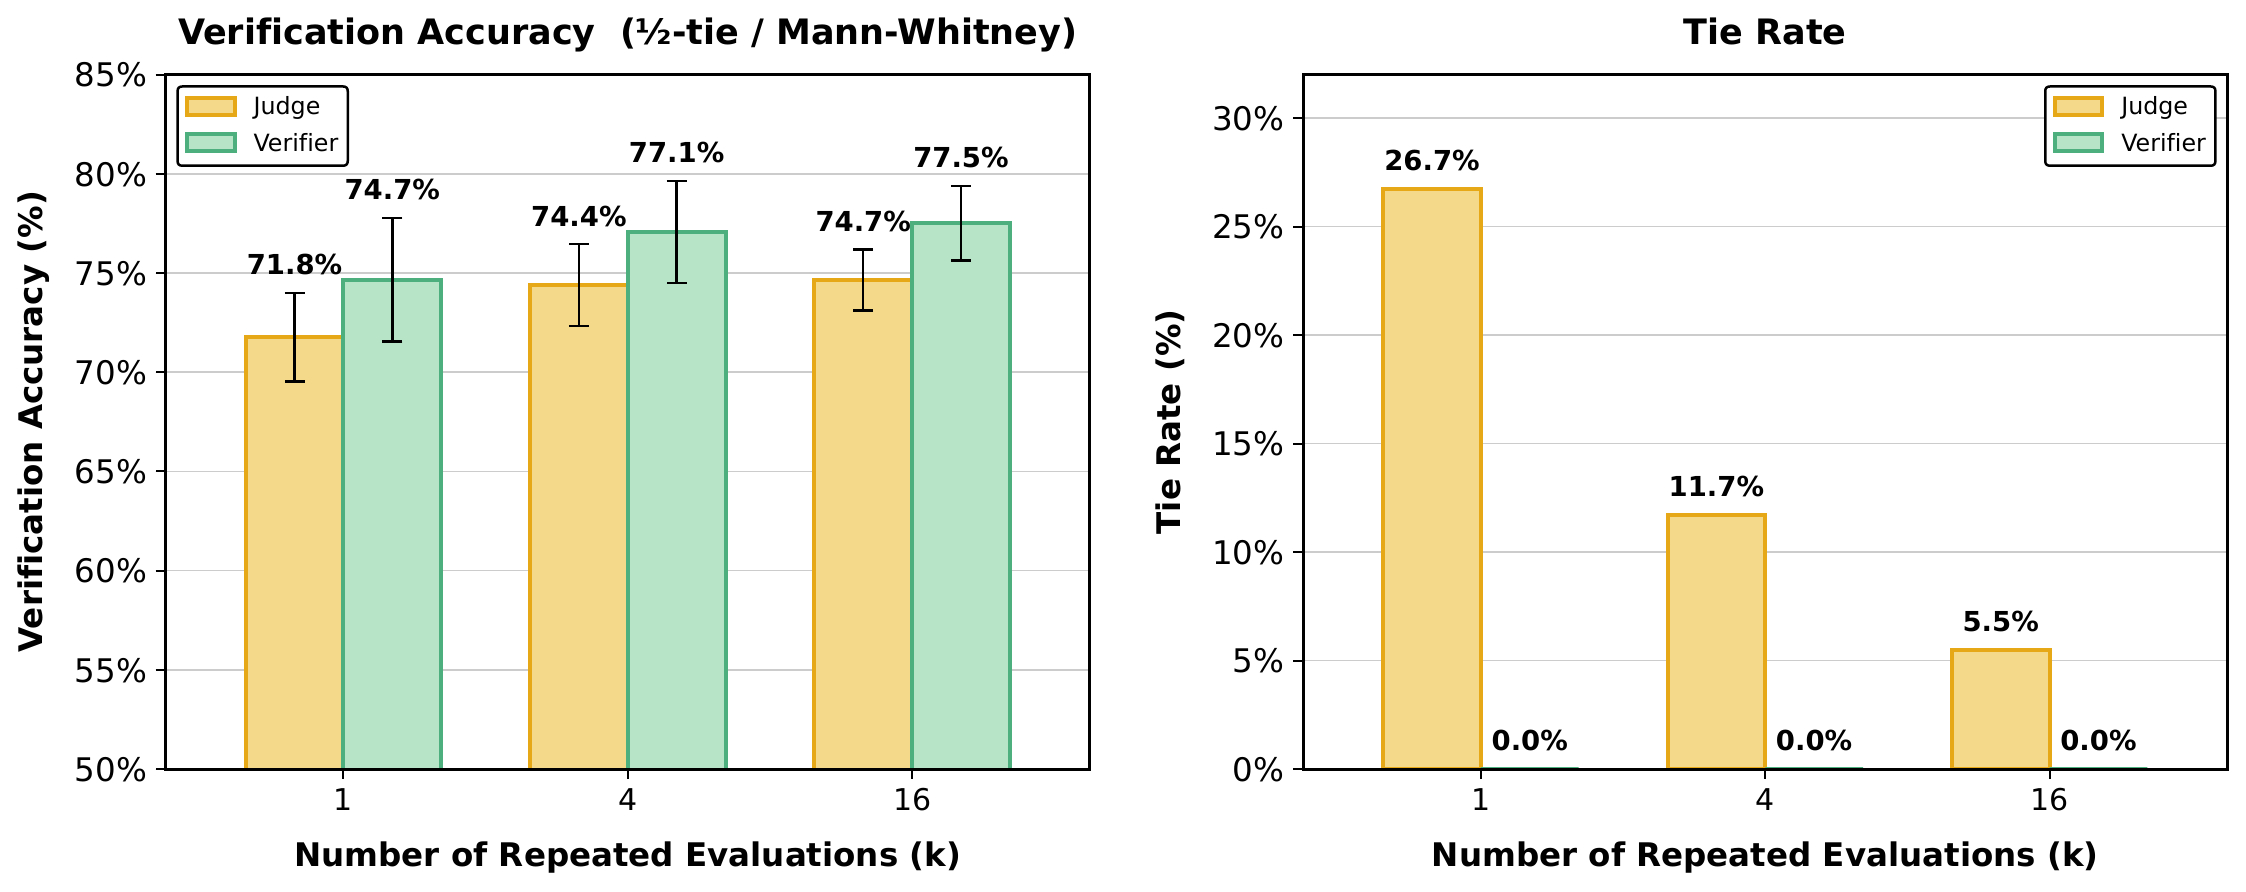
图 7。 连续 verifier 在 \(K=1\) 时已达 74.7%,到 \(K=16\) 为 77.5%,所有预算下都优于离散 judge。离散 judge 的平局率从 \(K=1\) 的 26.7% 降至 \(K=16\) 的 5.5%,连续 verifier 始终为零平局。
早期重复带来的收益主要来自方差降低;\(K\) 较大后,由于难例上的偏差彼此相关,边际收益递减。一个重要对照是:单次连续 verifier 已能匹配重复 16 次的离散 judge。
4.3 评价标准分解
粒度和重复评估都默认 rubric 本身足够好。如果一个整体标准不能反映轨迹质量,前两种扩展无法修复这个问题。
长时程 agent 任务中的“这条轨迹正确吗?”混合了多个逻辑上不同的因素。验证器面对复合问题时,可能只关注 prompt 中最显眼的一项。因此作者把代码 agent 的正确性拆成三个更容易检查的标准:
- Specification:轨迹是否满足任务的全部要求;
- Output:最终输出格式是否符合预期;
- Errors:日志和工具输出中是否不存在失败信号。
最终奖励对三个标准的期望分数取平均。单个标准的准确率在 75.2%–76.4% 之间,三个标准 ensemble 后达到 78.3%。
5 实验
作者把 LLM-as-a-Verifier 作为 trajectory reward model,在三个领域的四个 benchmark 上进行测试时扩展:
- 代码:Terminal-Bench V2、SWE-Bench Verified;
- 机器人:RoboRewardBench;
- 医疗:MedAgentBench。
统一流程是:生成策略 \(\pi_\theta\) 为每个任务产生 \(N\) 条候选轨迹;验证器用 PPT 进行成对比较;提交归一化分数最高的轨迹。除非另有说明,默认配置为 \(G=20\)、\(K=8\),并使用三个评价标准。
该方法不对验证器做领域微调。需要注意,论文报告的提升来自同一候选池上的选择,而不是把 proposal model 本身训练得更强。
| Benchmark | Pass@1 | Oracle Pass@\(N\) | LLM-as-a-Verifier |
|---|---|---|---|
| Terminal-Bench V2 | 83.1% | 92.1% | 86.5% |
| SWE-Bench Verified | 76.1% | 84.4% | 78.2% |
| MedAgentBench | 70.2% | 75.0% | 73.3% |
5.1 Terminal-Bench V2
Terminal-Bench V2 衡量 agent 在 shell 环境中完成长时程任务的能力,涉及多步推理、文件操作和工具失败恢复。它对验证器尤其困难,因为很多轨迹在语法上合理,最终终端状态却不正确。
实验使用 Capy scaffold,每个任务从 GPT-5.5 采样 \(N=5\) 条轨迹,以 Gemini 2.5 Flash 为验证器:
- GPT-5.5 + Capy 的 Pass@1:83.1%;
- 候选池的 Oracle Pass@5:92.1%;
- LLM-as-a-Verifier:86.5%。
论文列出的 leaderboard 对照包括 GPT-5.5 + NexAU-AHE 84.7%、Claude Mythos + Terminus-2 82.0%、Claude Opus 4.7 + WOZCODE 80.2%、Gemini 3.1 Pro + TongAgents 80.2%。附录还在 Terminus-2 与 Terminus-Kira 上复验,以排除收益只来自 Capy scaffold 的可能。
5.2 SWE-Bench Verified
SWE-Bench Verified 是 500 个真实 GitHub issue 的人工核验子集。每个任务要求 agent 提交能够解决 issue 并通过维护者隐藏测试的 patch,考验长上下文、跨文件编辑和遵循既有代码库约束的能力。
实验使用 mini-swe-agent scaffold。与 Terminal-Bench 的同质候选不同,这里每题的 \(N=3\) 个候选分别来自 Claude Opus 4.5、Gemini 3 Flash 和 MiniMax M2.5:
- 候选平均 Pass@1:76.1%;
- Oracle Pass@3:84.4%;
- LLM-as-a-Verifier:78.2%;
- 单模型对照:Claude Opus 4.5 为 76.8%,Gemini 3 Flash 与 MiniMax M2.5 均为 75.8%。
结果说明,验证器可以在不同模型家族产生的异构轨迹之间进行选择。
5.3 RoboRewardBench
RoboRewardBench 评价 reward model 对机器人操作轨迹的判断能力。给定遵循相同自然语言指令、但完成进度不同的两段 rollout 视频,模型要判断哪一段更接近目标。
输入是多帧视频,因此验证器必须整合跨帧视觉信息。实验以 Qwen 3.6 35B 为 VLM verifier,使用 \(G=20\)、\(K=8\),在 500 个随机轨迹 pair 上评估。
| 方法 | 轨迹偏好准确率 |
|---|---|
| TOPReward | 74.7% |
| Robometer-4B | 78.8% |
| RoboReward-8B | 81.4% |
| 同一 VLM 的离散 LLM-as-a-Judge | 70.8% |
| LLM-as-a-Verifier | 87.4% |
RoboReward-8B 使用约 4.5 万个 episode 训练,Robometer-4B 使用约 100 万个 pair;LLM-as-a-Verifier 则零样本应用,没有额外微调。
作者还比较预测奖励与人类标注的平均绝对误差(越低越好):
| 方法 | MAE |
|---|---|
| RoboReward-8B | 1.11 |
| RoboReward-8B + 连续 verifier reward | 0.72 |
5.4 MedAgentBench
MedAgentBench 评价 LLM agent 在模拟电子健康记录环境中的医疗任务,包括患者信息检索、指南查询和多步工具调用。该领域很难构建精确的轨迹 checker,而且验证错误可能带来实际安全后果。
实验使用 AgentBench harness,每个任务从 Claude Opus 4.8 采样 \(N=5\) 条轨迹:
- Claude Opus 4.8 Pass@1:70.2%;
- Oracle Pass@5:75.0%;
- LLM-as-a-Verifier:73.3%;
- Gemini 3.5 Flash:66.3%;
- GPT-5.5:65.1%。
6 用细粒度验证信号估计任务进度
除了选择最佳轨迹,连续验证分数还能表示 agent 已完成任务的程度。作者使用 Value-Order Correlation(VOC)量化这一点:对每个时间点的轨迹前缀打分,再计算步骤时间顺序与验证器预测 value 顺序之间的 Spearman rank correlation。
如果验证器能跟踪进展,它应当给成功 rollout 的后期前缀更高分,使 \(\mathrm{VOC}\rightarrow1\);对停滞或倒退的失败轨迹,分数则不应虚假上升。
6.1 代码生成中的 VOC
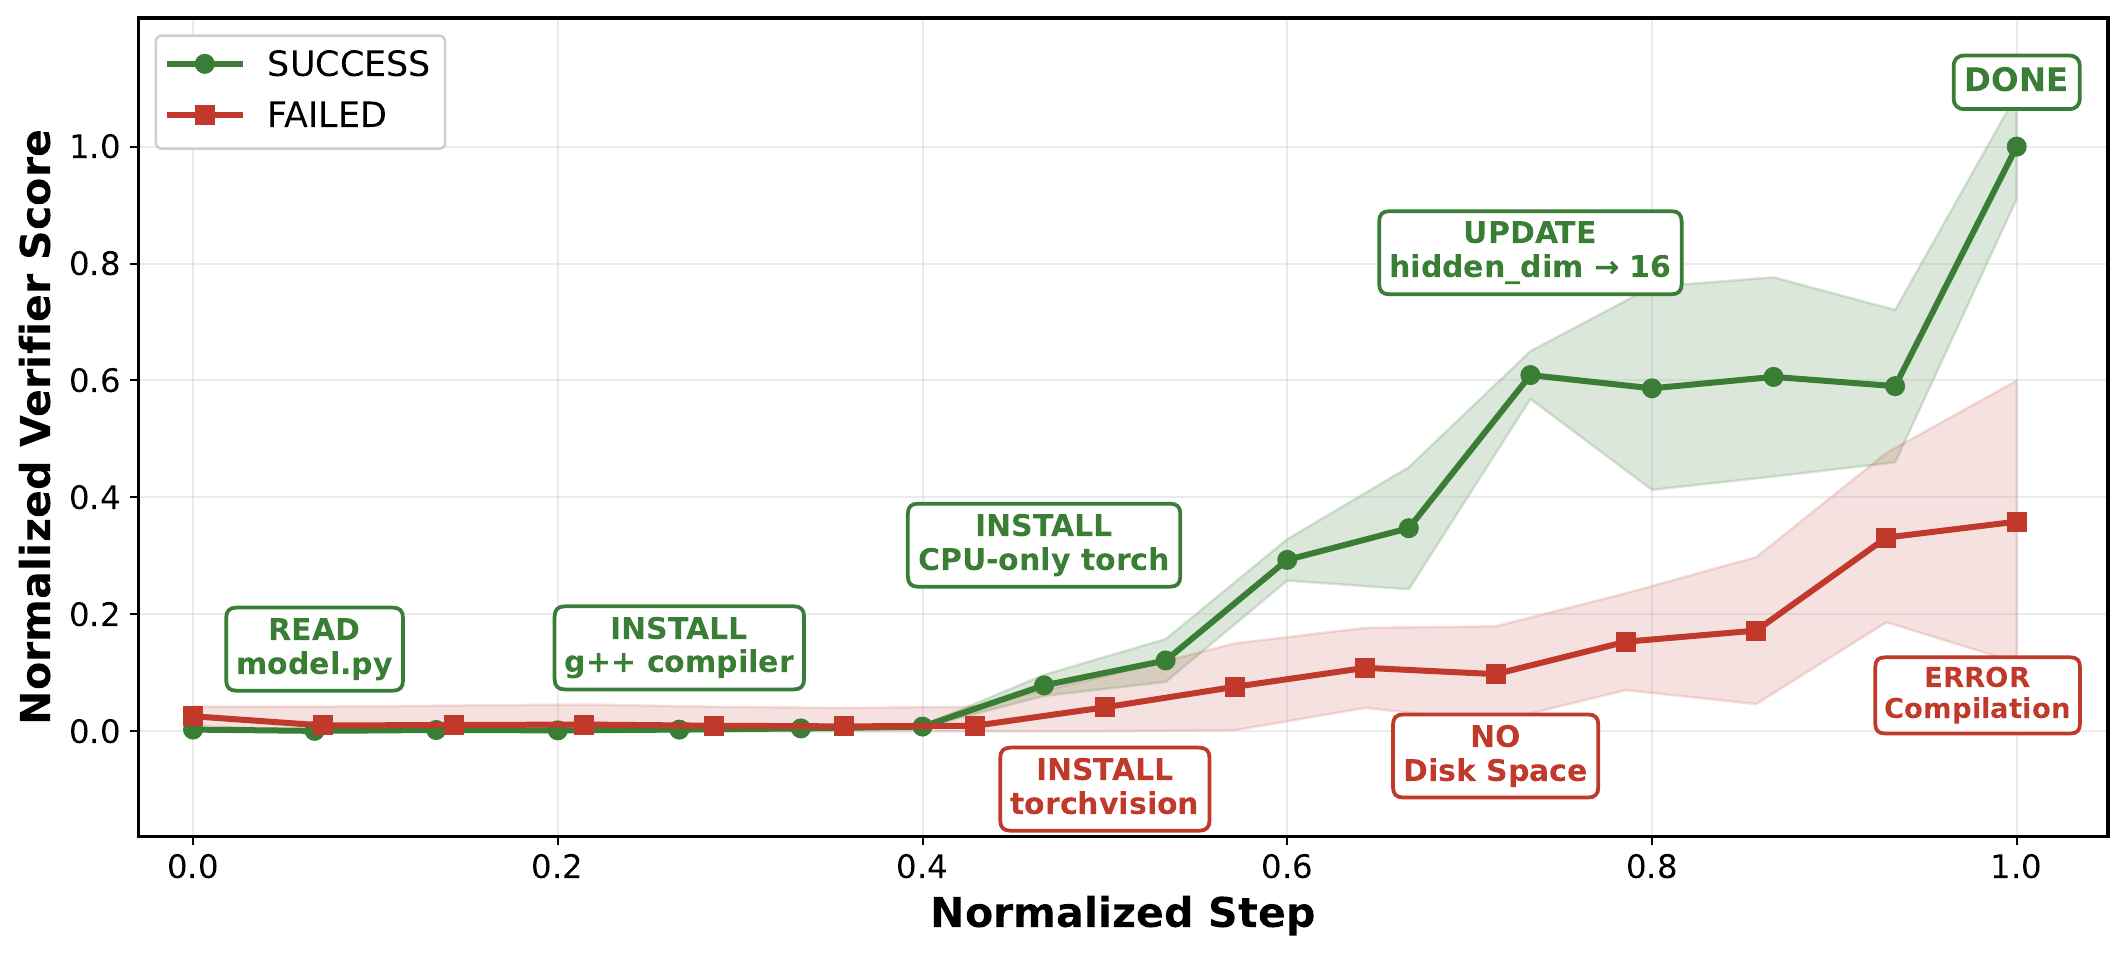
图 8。
pytorch-model-cli任务中,成功轨迹依次读取model.py、安装 g++、安装 CPU-only torch、更新hidden_dim并完成,验证分持续上升;失败轨迹误装庞大的torchvision,耗尽磁盘并编译失败,分数始终较低。
在 Terminal-Bench V2 随机抽取的 500 条轨迹上,Gemini 2.5 Flash、\(G=20\) 的结果为:
| 轨迹结果 | Spearman VOC |
|---|---|
| 成功 | \(0.848\pm0.012\) |
| 失败 | \(0.769\pm0.016\) |
| 成功 − 失败 | +0.079 |
失败轨迹也可能在早期做出进展,所以 VOC 不是简单的成功标签;但成功轨迹与时间顺序的相关性更强,约有 0.08 的差距。
6.2 机器人轨迹中的 VOC
作者在 RoboRewardBench 的 500 条 held-out 轨迹上计算 VOC:
| 方法 | Spearman VOC |
|---|---|
| LLM-as-a-Verifier,Qwen 3.6 35B,\(K=5,G=20\) | 0.966 |
| RoboReward-8B | 0.877 |
| Robometer-4B | 0.780 |
| TOPReward | 0.565 |
TOPReward 往往很早就饱和到 \(P(\mathrm{True})=1.0\),因此在最终失败的 rollout 中失去区分中间进度的能力。对整个评分分布取期望,则能保留更平滑、与时间顺序对齐的信号。
6.3 Coding agent 扩展
作者实现了 TurboAgent,它可作为 Claude Code 和其他 OpenAI API 兼容客户端的即插即用扩展。TurboAgent 是位于客户端与 LLM provider 之间的推理时代理,无需修改底层 agent harness 或模型。
每次请求时,它并行发送 \(N\) 条候选到后端模型,再用 PPT 选择最佳响应。它还提供 Web 界面,实时展示验证器输出和 agent 进度。相同代理设计也可接入 Terminal-Bench 等现有 benchmark。
7 用于强化学习的密集奖励
进度信号还能缓解 RL 的 credit assignment 问题。作者把 LLM-as-a-Verifier 的细粒度分数直接作为 off-policy 与 on-policy RL 的密集奖励,不训练额外 reward model,也不设计环境专用 shaping 函数。
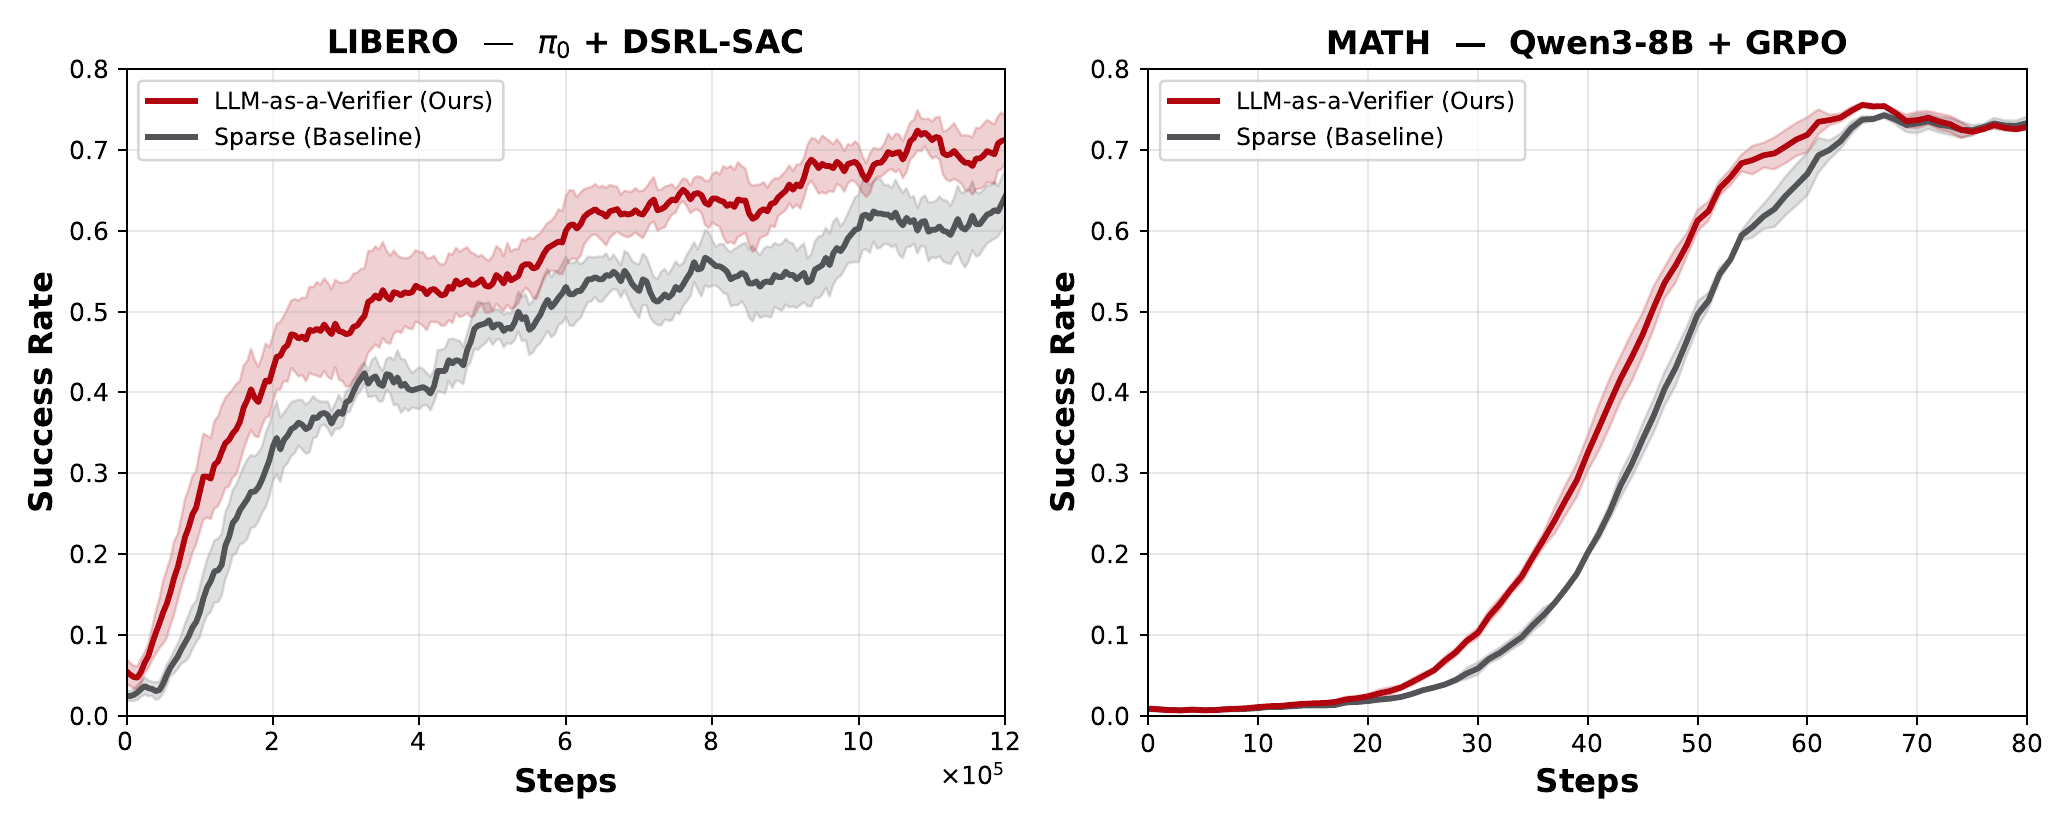
图 11。 左:LIBERO
ketchup上,DSRL-SAC 达到相同成功率所需环境步数约减少到稀疏奖励的 \(1/1.8\),最终成功率也从 0.69 提升到 0.76。右:MATH 上,GRPO 的样本效率提高约 1.1 倍。
7.1 Off-policy RL:DSRL-SAC 的密集进度奖励
作者在 LIBERO 上用 DSRL-SAC 微调 \(\pi_0\) vision–language–action policy。每个 rollout 结束后,把任务指令 \(x\) 和均匀采样的渲染帧交给 VLM verifier,得到每个步骤前缀的进度曲线:
随后重标记 rollout:
重标记后的 \((s_t,a_t,r_t,s_{t+1})\) 写入 replay buffer \(\mathcal{D}\),SAC critic 用 shaped return 训练。\(\lambda\) 控制环境奖励与验证器奖励的权衡。由于 shaping 离线应用于已存储轨迹,SAC 目标本身无需修改。
7.2 On-policy RL:GRPO 的密集推理奖励
作者在 MATH 上用 GRPO 微调 Qwen3-8B。GRPO 为每个 prompt 采样一组回答,并相对组内其他回答估计 advantage。训练早期经常出现整组最终答案都错误的情况,此时 group-relative advantage 全部为零,模型得不到梯度。
LLM-as-a-Verifier 用 PPT 比较每条 completion 的 reasoning trace,为每条回答给出归一化偏好分数 \(\bar R_i\in[0,1]\)。即使最终答案相同或全部错误,它仍能区分推理质量。
总奖励写作:
7.3 实证结果
在相同 policy、optimizer、随机种子和评估协议下,唯一变化是奖励:
- LIBERO:在目标成功率 0.2–0.6 的范围内,验证器 shaping 的样本效率约为稀疏奖励的 1.8 倍,最终成功率 0.76 对 0.69;
- MATH:加入 reasoning reward 后约提高 1.1 倍样本效率,即达到相同准确率所需 optimizer steps 减少约 10%。
8 讨论
本文认为,验证是一个尚未充分探索的扩展轴。LLM-as-a-Verifier 的核心变化看似简单:不再输出一个离散分,而是对评分 token logits 分布求期望。这个连续奖励使验证可以沿评分粒度、重复评估和标准分解三个维度系统扩展。
作为测试时 trajectory reward model,它在代码、机器人与医疗 benchmark 上从候选池中恢复了部分 oracle headroom。作为进度估计器,它能监控 agent 是否在向目标推进。作为 RL 奖励,它又能为稀疏任务补充中间反馈。
这些用途共享同一个信号,但不应混为一谈:
- 排序实验衡量能否从已有候选中选得更好;
- VOC 衡量分数是否与轨迹时间进展一致;
- RL 实验衡量这个分数作为训练奖励时能否提高样本效率。
9 相关工作
9.1 测试时扩展
测试时扩展通过在推理阶段投入更多计算提高性能。一条路线通过 chain-of-thought、问题分解和对多条推理路径做边缘化来改进单个回答;另一条路线搜索中间 thought、action 或 latent world state。重复采样与 Best-of-\(N\) 则扩大候选池。
这些方法能够暴露很大的 oracle headroom,但要把 headroom 转化为实际结果,必须有可靠 selector。本文的重点不是继续扩大生成,而是扩大验证器的粒度、重复次数与评价维度,以改进长时程候选选择。
9.2 LLM-as-a-Judge
LLM-as-a-judge 通过让大模型打分或比较生成结果,提供比人工评测更可扩展的方案。已有研究使用概率加权、表单填充、定制 rubric、技能分解、层级标准、专用 open judge、多 judge debate 与 ensemble,并分析位置偏差、公平性、自我偏好和认知偏差。
LLM-as-a-Verifier 与这些工作不同之处在于:它面对的不是孤立自然语言回复,而是包含工具使用、代码执行、机器人动作和医疗决策的长时程轨迹;同时它明确研究验证质量如何随评分粒度、重复评估和标准分解扩展。
9.3 可验证奖励
reward model 把候选解、动作或轨迹映射成选择、监控或 policy optimization 所需的标量反馈。语言推理中已有 ORM、PRM 和 generative verifier;机器人领域则使用视觉表征、VLM feedback、语言生成 reward code、token 概率进度和经过大规模轨迹数据训练的 reward model。
另一类方法把整体判断分解成更小的检查,提高 factuality 与 action verification 的可靠性。本文与这些方法正交:它以冻结的 LLM/VLM 为基础,在多个领域统一研究验证扩展,而无需为每个领域训练新 reward model。
10 局限与未来工作
当前框架有三类主要局限:
- 需要评分 token logits。 一些仅通过受限 API 提供的 frontier model 不返回 token-level logprobs,不能直接替换验证器 backbone。附录给出两阶段变通方案,但增加了系统复杂度。
- 扩展轴并不完备。 当前评价标准主要由人工设计;未来可以按领域学习或动态生成标准。固定次数重复评估也可替换成由验证器不确定性指导的自适应计算分配。
- RL 实验仍限于 single-turn。 真正的 multi-turn agent RL 需要在长时程 rollout 的许多相互依赖动作之间进行 per-step credit assignment,本文尚未验证。
此外,候选选择的上限由候选池本身决定。如果生成策略没有产生正确或接近正确的解,验证器不能凭空创造答案。
11 补充结果与分析
11.1 Terminal-Bench 上的 harness 泛化
为验证收益不是某个 scaffold 的特例,作者在主实验的 Capy 之外,使用 Terminus-Kira + Claude Opus 4.6 和 Terminus-2 + GPT-5.3-Codex 重复实验。每题仍采样 \(N=5\),验证器仍为 Gemini 2.5 Flash,配置保持 \(G=20\)、\(K=8\) 和三个标准。
| Agent harness | LLM-as-a-Verifier | Claude Opus 4.6 | Gemini 3.1 Pro |
|---|---|---|---|
| Terminus-Kira(Opus 4.6 proposals) | 79.4% | 74.7% | 74.8% |
| Terminus-2(GPT-5.3-Codex proposals) | 71.2% | 62.9% | 68.5% |
Terminus-Kira 提高约 5 个点;绝对性能较弱的 Terminus-2 仍比 Gemini 3.1 Pro 高 2.7 个点、比 Claude Opus 4.6 高 8.3 个点。作者据此认为,验证器关注的是终端状态和任务进度,而非 scaffold 特有的表面格式。
11.2 PPT 的预算—准确率权衡
完整 PPT 算法可以概括为:
- 从生成策略采样 \(N\) 条轨迹;
- 初始化每条轨迹的 soft win mass \(w_i\) 和比较次数 \(c_i\);
- 采样随机环并比较相邻候选;
- 按 \(w_i/c_i\) 选择 top-\(k\) pivots;
- 比较所有 non-pivot–pivot 与 pivot–pivot pair;
- 返回 \(w_i/c_i\) 最大的轨迹。
作者在 Terminal-Bench V2 的 89 个任务上,每题整理 \(N=20\) 条 Terminus-2 轨迹:
| 方法 | 查询 pair 数 | 准确率 |
|---|---|---|
| Pass@1 | — | 52.64% |
| V1,\(1N\) budget | 1,400 | 64.64% |
| V1,\(3N\) budget | 4,200 | 65.62% |
| V1,\(5N\) budget | 7,000 | 65.85% |
| V1,\(7N\) budget | 9,800 | 65.53% |
| PPT,\(k=1\) | 2,570 | 65.83% |
| PPT,\(k=3\) | 4,723 | 66.17% |
| PPT,\(k=5\) | 6,609 | 66.27% |
| PPT,\(k=7\) | 8,242 | 66.67% |
| PPT,\(k=9\) | 9,630 | 67.13% |
| Full round-robin | 13,111 | 67.42% |
\(k=3\) 时 PPT 已超过表中最佳 V1;\(k=9\) 时距完整循环赛仅 0.29 个百分点,但比较数明显更少。
11.3 作为 PRM 与 ORM
作者进一步把 LLM-as-a-Verifier 用作 agent 逐步选择的 PRM,以及代码和数学 Best-of-\(N\) 的 ORM。
作为 PRM,每个步骤采样更多候选动作后,Pass@1 单调上升:
| 每步采样动作数 | \(k=1\) | \(k=3\) | \(k=5\) | \(k=9\) |
|---|---|---|---|---|
| TauBench,Gemini 2.5 Flash | 48.7 | 54.0 | 55.1 | 55.7 |
| Terminal-Bench,Gemini 3 Flash | 49.8 | 51.4 | 52.0 | 54.3 |
论文称其计算量约为 V1 的三分之一。
作为 ORM,结果如下:
| 方法 | SWE-Bench Lite | AIME | HMMT |
|---|---|---|---|
| Base model | 23.5 | 71.5 | 52.0 |
| Pointwise LM judge,\(N\) budget | 29.7 | 83.3 | 63.5 |
| Pairwise V1,\(3N\) budget | 31.0 | 86.0 | 73.3 |
| LLM-as-a-Verifier,\(2N\) budget | 33.0 | 90.0 | 73.3 |
相对 base model,绝对提升分别为 SWE-Bench Lite 9.5、AIME 18.5、HMMT 21.3 个点。
11.4 query-optimize 完整案例
任务要求:
给定
/app/oewn.sqlite中 SQLite 格式的 Open English Wordnet 数据库,以及/app/my-sql-query.sql中一条未优化查询。请在确保输出相同的前提下尽可能优化查询,把无注释、只含一条并以分号结束的 SQLite 查询保存到/app/sol.sql。
两条候选都保存了优化查询,并声称内部 diff 通过,但隐藏 grader 给一条 reward 1、另一条 reward 0。错误轨迹的验证方法不成立:
- 它两次尝试在
/app/oewn.sqlite上运行原查询,分别在 60 秒和 5 分 02 秒后中止。 - 为获得参考输出,它把数据库复制到
/tmp/oewn_test.sqlite,再给副本的senses(wordid)、senses(synsetid)和synsets(synsetid)建索引。 - 它随后比较“索引副本上的原查询”和“canonical、无索引数据库上的优化查询”。两种物理访问路径在
LIMIT 500边界处不保证以同样方式打破相同ORDER BYkey 的平局。 - 它删除了数据库副本与所有输出文件,使验证证据无法复查。
- 因此,优化查询从未在 grader 使用的 canonical、无索引数据库上与原查询进行真正等价验证,
sol.sql最终未通过隐藏测试。
正确轨迹则在 canonical database 上等待原查询完整执行 5 分 03 秒,再运行直接 diff,退出码为 0。
在启用 thinking 的 16 条 reasoning trace 中,Gemini 2.5 Flash 能稳定指出:复制数据库并添加索引改变了用于产生参考输出的条件,因此不能证明优化查询与原查询在原始数据库上等价。
11.5 RoboRewardBench 的重复评估与视觉上下文
机器人轨迹偏好准确率从 \(K=1\) 的 81.5% 提升到 \(K=8\) 的 87.4%,随后在较大 \(K\) 处接近噪声下限并趋于饱和。所有预算下,LLM-as-a-Verifier 都优于离散 LLM-as-a-Judge、TOPReward、RoboReward-8B 和 Robometer-4B。这说明重复评估的收益可以从文本迁移到多帧视频。
11.6 不提供 logits 的 frontier model
LLM-as-a-Verifier 需要访问评分 token logits。一些 frontier API 只返回采样 completion,不返回 token-level logprobs,因而不能直接用 GPT-5.5 或 Claude Opus 4.7 替换 verifier backbone。
作者提出两阶段方案:
- 让闭源强模型分析两条轨迹,输出自由形式 reasoning,再给出离散 1–10 分;
- 把任务、两条轨迹和第一阶段 reasoning 一起交给可读取 logits 的 Gemini 2.5 Flash,并在
<score_A>、<score_B>位置提取连续奖励。
第一阶段提供强模型的领域推理,第二阶段提供闭源 API 不公开的校准概率分布。
在 Terminal-Bench V2 swing-pair 集合上,每个 pair 生成 16 条 GPT-5.5 reasoning trace,再进行 16 次 Gemini 2.5 Flash 评分;每个 \(K\) 用 400 次 bootstrap 子采样估计均值:
| \(K\) | GPT-5.5 离散准确率 | 离散平局率 | 两阶段连续准确率 | 连续平局率 |
|---|---|---|---|---|
| 1 | 74.9% | 10.9% | 80.1% | 0.0% |
| 2 | 76.3% | 9.1% | 80.5% | 0.0% |
| 4 | 77.6% | 7.0% | 81.0% | 0.0% |
| 8 | 78.4% | 5.8% | 80.9% | 0.0% |
| 16 | 79.1% | 5.0% | 81.2% | 0.0% |
\(K=1\) 时,两阶段方案高 5.2 个点并消除 10.9% 的平局。连续方案从 \(K=1\) 到 16 只提高 1.1 个点,很快饱和;离散方案主要依靠大量 ensemble 打破平局。即使 \(K=16\),连续方案仍领先 2.1 个点且保持零平局。
11.7 RL 实验细节
两个 RL 设置中,baseline 与本文方法唯一不同的是 reward;policy、optimizer、超参数、评估协议和随机种子均保持一致。
Off-policy:DSRL-SAC
- 任务:LIBERO-90
ketchup; - policy:\(\pi_0\);
- verifier:通过 SGLang 部署的 Qwen 3.6 35B;
- 每个 rollout 均匀采样 \(N_f=10\) 个渲染帧;
- 粒度 \(G=20\),重复 \(K=3\),\(\lambda=1\);
- 默认只对成功 rollout 做 reward shaping;代码也支持重标记成功与失败 rollout;
- 每个条件运行 5 个随机种子,训练到 150 万环境步。
On-policy:GRPO
- 模型:Qwen3-8B;
- 数据:Hendrycks MATH;
- 训练工具:Tinker;
- group size:\(M=16\);
- 每个 optimization batch:64 个 group;
- learning rate:\(2\times10^{-5}\);
- 最大生成长度:512 tokens;
- verifier:Gemini 2.5 Flash,以 PPT 评价 reasoning trace;
- 组内标准化偏好后,以 \(\beta=0.1\) 加入 correctness 与 format reward。
致谢
作者感谢 Rohan Chandra、Ken Goldberg、Sherry Yang、Marcin Michalski、Alex Tung、Shengjie Bi、Jimmy Wu、Fred George、Mark Ren、Mohit Shridhar、Haotian Xue、Dorsa Sadigh、Richard Liaw、Homanga Bharadhwaj、Jitendra Malik、Simran Arora、Haochen Shi、Kuan Fang、Tianjun Zhang、Matan Jacob、Jiaming Song、Yilun Du、Xue Bin Peng、Lerrel Pinto、Abhishek Gupta、Huy Ha、Karl Pertsch、Alexandre Piché、Vivek Myers、Shubham Tulsiani、Kameron Decker Harris、Alex Ratner 与 Lee Spector 的讨论和反馈。
参考文献
参考文献条目及正式题名保持原论文形式,完整列表见本地 paper.pdf 第 14–17 页与 source/ref.bib。本文译文中的模型、benchmark、算法和数据集名称均保留英文,以便与原文及代码对应。