LLM-as-a-Verifier: A General-Purpose Verification Framework¶
笔记时间:2026-07-28 评分:5 领域:verification 子领域:trajectory_scoring 方法:gen-verifier, test-time 类型:framework
元信息¶
- ID: arXiv:2607.05391v2
- 年份: 2026
- 作者: Jacky Kwok, Shulu Li, Pranav Atreya, Yuejiang Liu, Yixing Jiang, Chelsea Finn, Marco Pavone, Ion Stoica, Azalia Mirhoseini
- 机构: Stanford University;UC Berkeley;NVIDIA Research
- 项目:
https://llm-as-a-verifier.com - 代码:
https://github.com/llm-as-a-verifier/llm-as-a-verifier - 插件: TurboAgent(Claude Code / OpenAI-compatible clients)
- 本地 PDF:
paper.pdf(31 页) - 英文全文:
main_en.md - 中文译文:
main_zh.md - LaTeX 源码:
source/
先说核心判断¶
这篇论文的核心不是训练一个新的 reward model,而是改变已有 LLM/VLM 的评分信号如何被读取和使用:普通 LLM judge 通常只取概率最高的评分 token,得到一个离散等级;LLM-as-a-Verifier 则保留预设的 \(G\) 个 scoring tokens 上的概率分布,对各评分值计算加权期望,得到不再局限于整数档位的实数轨迹分数。
这个看似很小的改动带出了一套完整框架:
- 用更细的评分 token、重复评价和 criteria decomposition 扩展 verification compute。
- 用 Probabilistic Pivot Tournament 在有限预算下从多条候选轨迹中选出最好的一条。
- 把同一连续信号复用于测试时选择、任务进度监控和 RL dense reward。
- 将框架实现为 TurboAgent,让 Claude Code、Codex 等 coding clients 可以直接接入候选选择和实时进度监控。
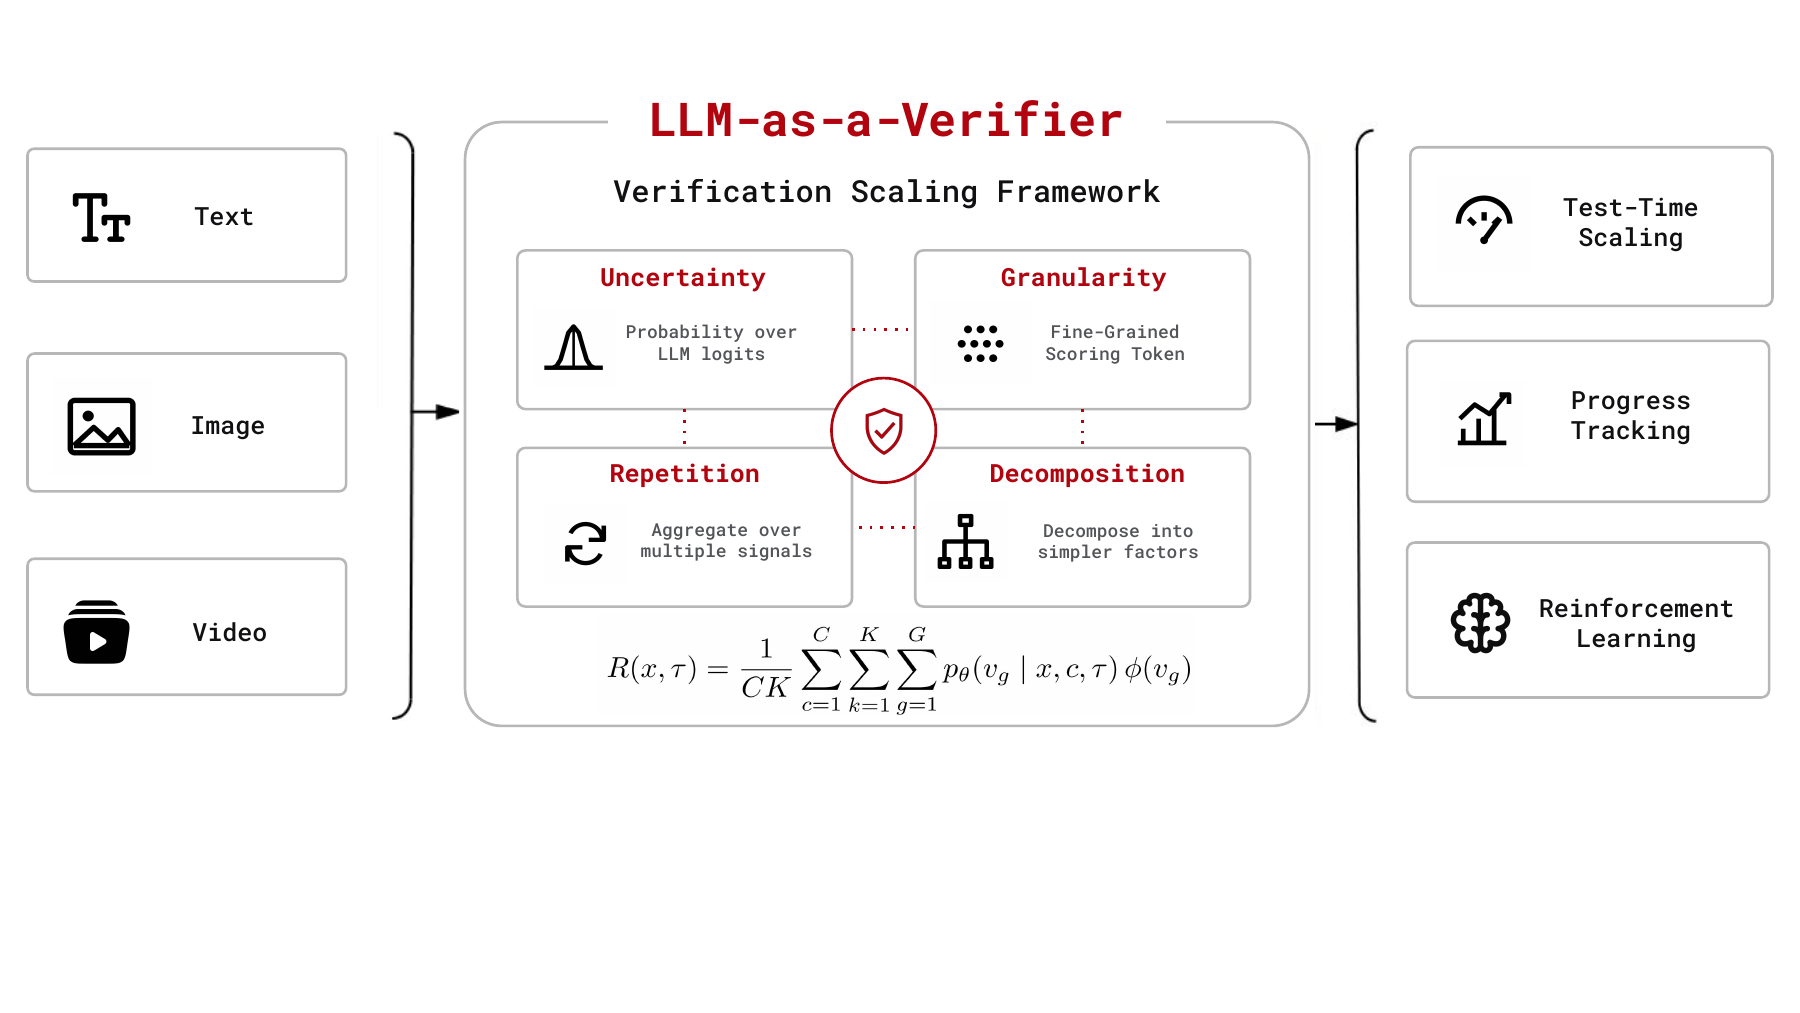
论文图 2。 文本、图像和视频轨迹都进入同一套 verification framework。图中央其实可以拆成三个可调旋钮:评分粒度 \(G\)、重复次数 \(K\)、criteria 数量 \(C\);uncertainty 不是第四个旋钮,而是作者希望通过完整 logit 分布保留下来的信息。右侧三种用途共用同一个连续信号。
最重要的边界也应先说清:它提升的是候选选择,不是 proposal model 的单次生成能力。 测试时仍然要先有一个 agent 或 policy 生成 \(N\) 条轨迹,verifier 只能从候选池中挑选,不能在候选全部失败时凭空构造正确答案。
真正的瓶颈:不是从未生成正确答案,而是选不出来¶
论文的出发点是 oracle headroom。作者汇总 Terminal-Bench V2 leaderboard 的多条轨迹后发现:如果存在完美 verifier,总能从候选中挑出正确轨迹,Pass@\(N\) 最终可到 98.9%(§4 Motivation)。这说明相当多任务已经“至少成功过一次”,但现实系统不知道哪一次成功。
普通离散 judge 在这里有两个问题:
- 它把模型对多个评分 token 的概率分布压成一个 argmax,丢掉不确定性。
- 长轨迹的质量差异往往很细,多个候选容易被四舍五入成相同整数分,形成 tie。
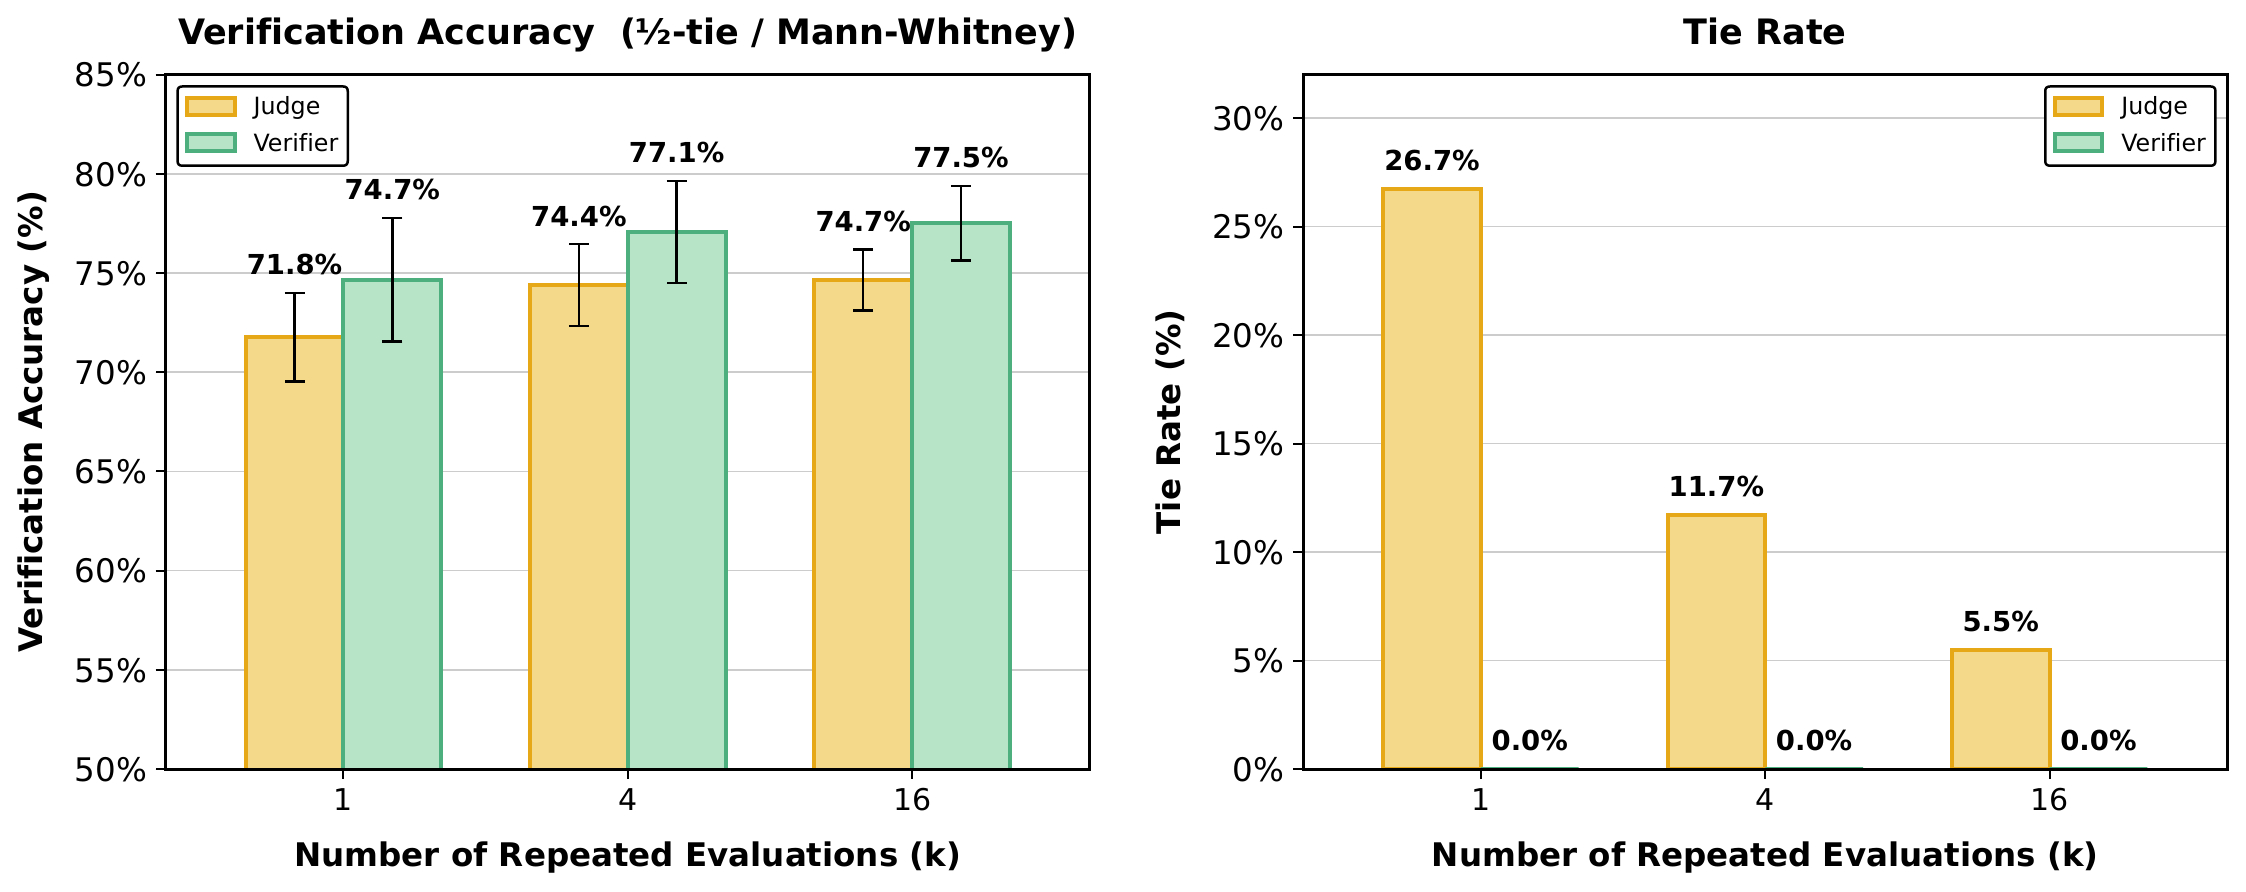
论文图 7。 在 Terminal-Bench V2 的成对验证中,连续 verifier 在 \(K=1,4,16\) 下分别取得 74.7%、77.1%、77.5%,离散 judge 为 71.8%、74.4%、74.7%。更关键的是右图:judge 的 tie rate 从 26.7% 降到 5.5% 仍未消失,而连续 verifier 始终为 0。重复采样能缓解离散分数的 tie,但不能消除量化本身的信息损失。
论文的 query-optimize 案例把问题展示得更具体:正确轨迹在原始数据库上等待查询完成并直接比较输出,失败轨迹却复制数据库、添加索引后再验证,破坏了等价性条件。Gemini 2.5 Flash 的文字推理能识别这个错误,但措辞仍很犹豫,于是离散分数经常被压成相同的 5 分。
| 读取评分的方法 | 正确轨迹更高 | 平分 | 错误轨迹更高 |
|---|---|---|---|
| 离散 judge,\(G=5\) | 12/100 | 88/100 | 0/100 |
| 连续期望,\(G=5\) | 69/100 | 0/100 | 31/100 |
| 连续期望,\(G=20\) | 77/100 | 0/100 | 23/100 |
这里也暴露了方法的真实性质:连续化消除了 tie、提高了排序概率,但它没有让 verifier 变成确定性 checker。即使 \(G=20\),仍有 23/100 次把失败轨迹排得更高。
从评分 token 分布得到连续轨迹价值¶
理解公式前只需要一个前提:LLM 在输出最终评分 token 时,本来就会给每个候选 token 一个概率。普通 judge 只拿概率最大的那个 token;本文保留整个有序评分集合
再用 \(\phi(v_g)\) 把第 \(g\) 个评分 token 映射为数值。给定任务 \(x\)、候选轨迹 \(\tau\) 和评价标准 \(c\),单次连续分数就是评分分布的期望。论文进一步对 \(C\) 个 criteria 和 \(K\) 次独立评价求平均:
三个求和分别承担不同职责:
- \(G\) 决定一次评分能表达多细的差异。
- \(K\) 用 Monte Carlo 平均降低单次评价方差。
- \(C\) 把一个复杂整体判断拆成多个简单判断,再做 ensemble。
例如,模型若对相邻的 15 分和 16 分分别给出 0.45、0.40 的概率,argmax 只会留下 15;期望则会保留“接近 16、但不确定”的信息。这个示例只是解释计算方式,不是论文实验数据。
作者先把 \(R\) 线性归一化到 \([0,1]\),再用 Bradley-Terry 形式把两条轨迹的分数差转成软偏好:
这不是 verifier 的训练 loss。主框架是 training-free 的:底层 LLM/VLM 保持冻结,偏好概率只用于 test-time ranking;后面的 RL 实验则把 \(R\) 当成下游 policy 的奖励信号。
三种 verification scaling 解决三种不同误差¶
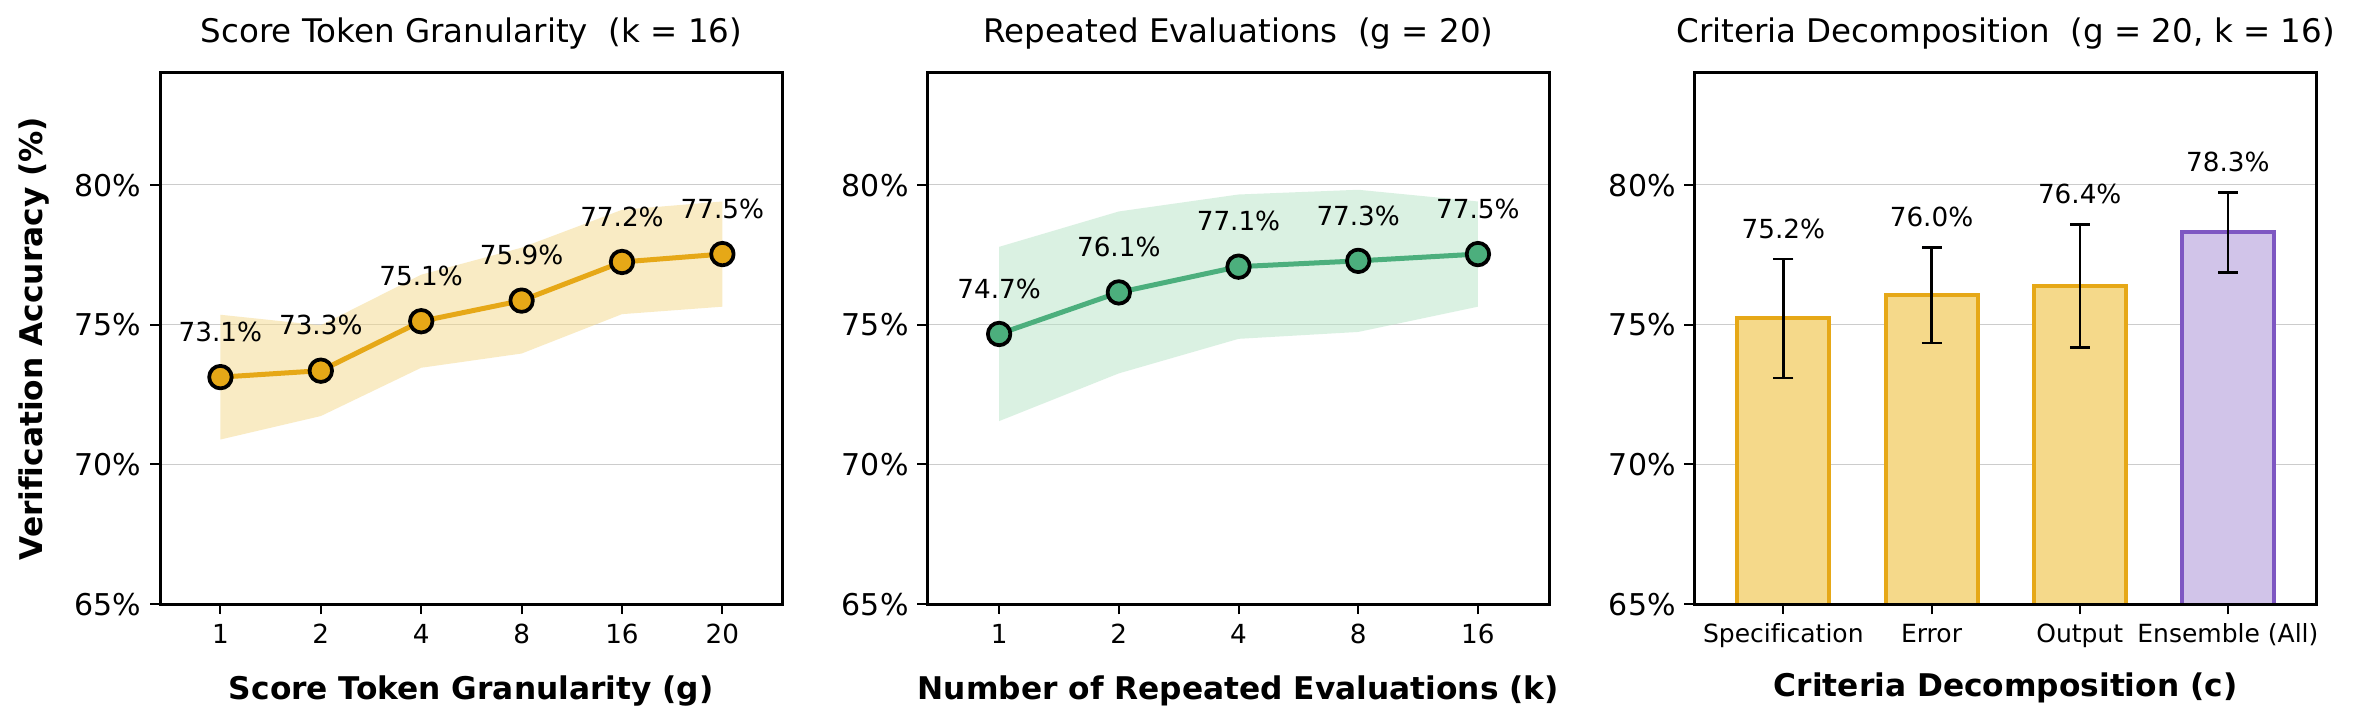
论文图 4。 三个旋钮都提高 Terminal-Bench V2 的 pairwise verification accuracy,但作用机制不同,不能简单理解为“多花几倍算力就行”。实验使用 Gemini 2.5 Flash,在 200 条跨 harness 轨迹上评估。
1. Score-token granularity \(G\):减少量化损失。
把评分集合从 1 个 token 扩到 20 个 token,accuracy 从 73.1% 提升到 77.5%。对应的正确/错误轨迹分数差信噪比从 0.775 升到 0.799。它没有给模型增加新的轨迹信息,只是给内部判断提供更细的表达坐标。
2. Repeated evaluation \(K\):降低单次采样方差。
\(K\) 从 1 增至 16,accuracy 从 74.7% 升到 77.5%。若各次评价近似独立,均值方差会按 \(O(1/K)\) 缩小;实际收益逐渐饱和,因为多次评价仍共享相关偏差。论文还发现连续 verifier 的单次评价已经约等于离散 judge 重复 16 次的准确率。
3. Criteria decomposition \(C\):降低复合判断的认知负担。
代码 agent 轨迹被拆成 Specification、Error、Output 三项,单项 accuracy 为 75.2%/76.0%/76.4%,三项 ensemble 达 78.3%。这与增加 \(K\) 不同:\(K\) 重复同一个问题,\(C\) 改变问题本身,把容易互相干扰的因素拆开。
主结果默认使用 \(G=20\)、\(K=8\) 和三个 criteria。它们都需要额外 inference compute,因此论文所谓 “verification scaling” 本质上是给 verifier 分配更多、更有结构的测试时预算。
有了连续偏好,怎样避免 \(O(N^2)\) 全量比较¶
\(N\) 条候选若全部两两比较,需要 \(\binom{N}{2}\) 组 pair query。作者提出 Probabilistic Pivot Tournament(PPT),只让所有候选与少量高质量 pivots 比较。
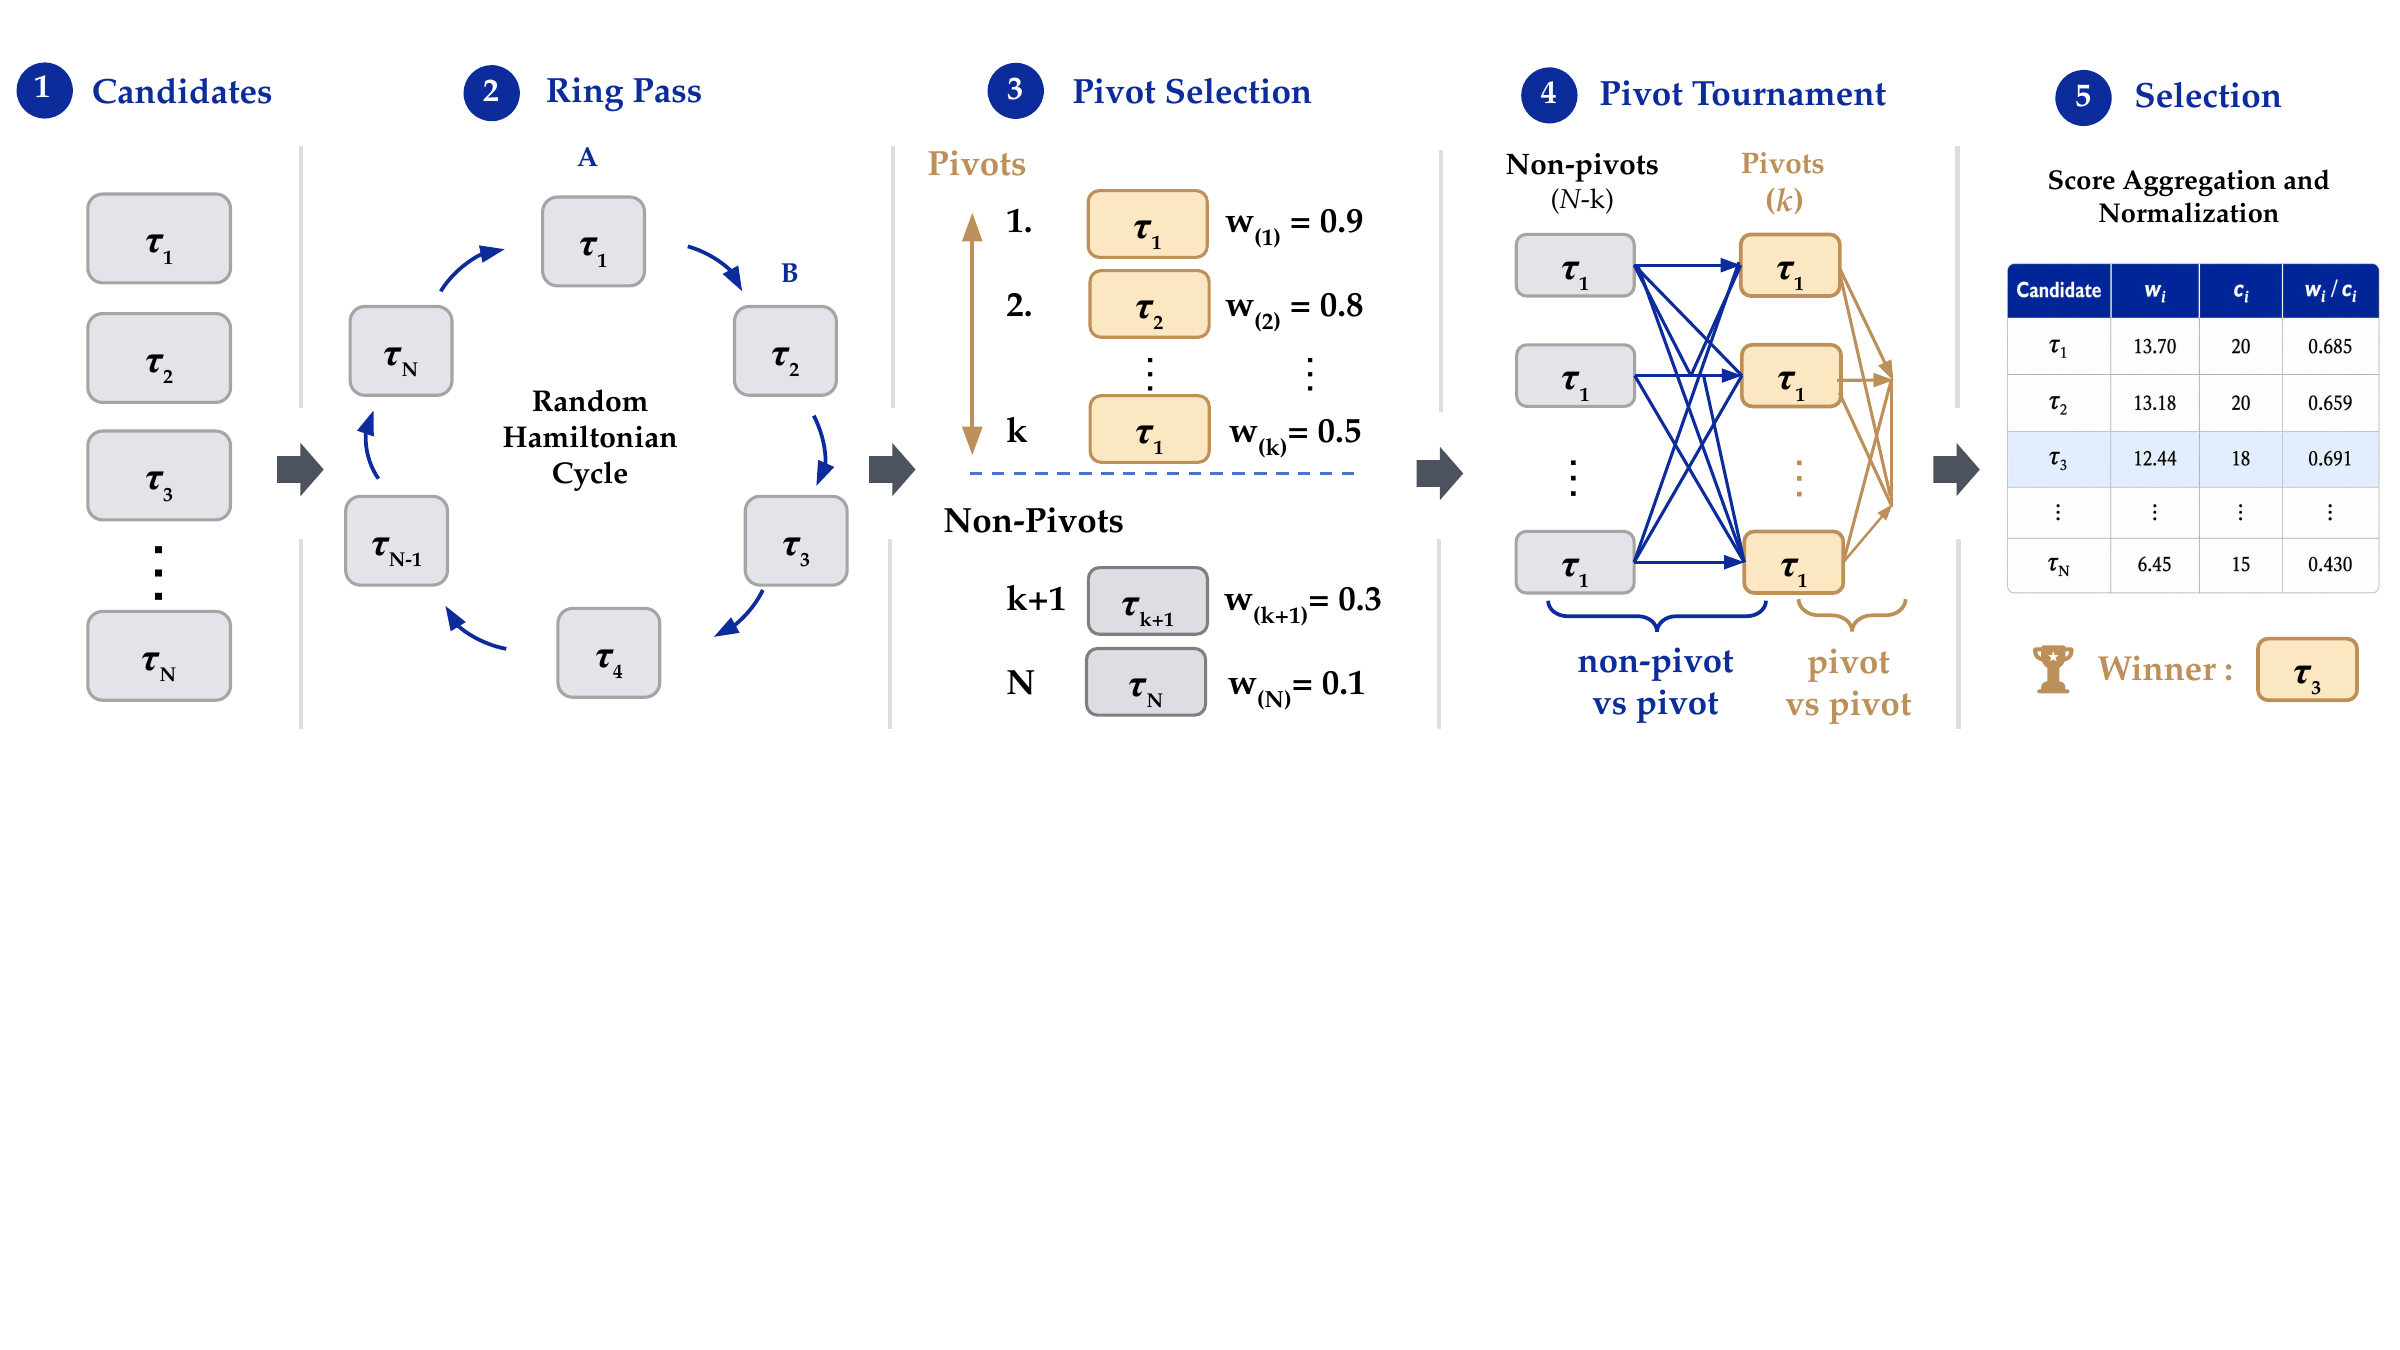
论文图 6。 第一轮把候选随机排成 Hamiltonian 环,每条轨迹恰好一次处于 A、一次处于 B,从统计上抵消位置偏置;根据 ring score 选 top-\(k\) pivots;之后只做 non-pivot vs pivot 和 pivot vs pivot;最后用累计 soft win \(w_i\) 除以比较次数 \(c_i\),避免 pivots 因参赛更多而占便宜。
总比较数约为
量级从 \(O(N^2)\) 降为 \(O(Nk)\)。在 89 个 Terminal-Bench V2 任务、每题 \(N=20\) 条 Terminus-2 轨迹上(附录 PPT ablation):
| 方法 | pair queries | Selection accuracy |
|---|---|---|
| PPT,\(k=3\) | 4,723 | 66.17% |
| PPT,\(k=5\) | 6,609 | 66.27% |
| PPT,\(k=9\) | 9,630 | 67.13% |
| Full round-robin | 13,111 | 67.42% |
\(k=9\) 省下约 27% 的 pair queries,accuracy 只比 round-robin 低 0.29 个百分点。这里 PPT 的价值不是创造更强 verifier,而是把预算集中在最可能胜出的候选附近。
主结果到底证明了什么¶
主实验固定 protocol:proposal policy 先生成候选池,LLM-as-a-Verifier 用 \(G=20\)、\(K=8\) 和 criteria decomposition 做 pairwise selection。
| Benchmark | Pass@1 | Oracle Pass@\(N\) | LLM-as-a-Verifier | 相对 Pass@1 |
|---|---|---|---|---|
| Terminal-Bench V2 | 83.1% | 92.1% | 86.5% | +3.4 |
| SWE-Bench Verified | 76.1% | 84.4% | 78.2% | +2.1 |
| MedAgentBench | 70.2% | 75.0% | 73.3% | +3.1 |
- Terminal-Bench V2:GPT-5.5 + Capy 每题生成 5 条轨迹,Gemini 2.5 Flash 验证。结果恢复了 oracle headroom 的约 38%。附录在 Terminus-Kira 和 Terminus-2 上仍有提升,说明方法不只适配 Capy 的轨迹格式。
- SWE-Bench Verified:每题候选分别来自 Claude Opus 4.5、Gemini 3 Flash、MiniMax M2.5,说明 verifier 可以在异构模型轨迹之间选择,而不只是给同一模型重采样排序。
- MedAgentBench:Claude Opus 4.8 每题生成 5 条医疗 agent 轨迹,选择后从 70.2% 到 73.3%。这里的结果仍来自模拟 EHR benchmark,不能直接外推为临床安全保证。
机器人实验不适合放进上表,因为 RoboRewardBench 测的是轨迹对偏好准确率,不是 task pass rate:
| RoboRewardBench 方法 | Preference accuracy |
|---|---|
| 同一 VLM 的离散 LLM-as-a-Judge | 70.8% |
| TOPReward | 74.7% |
| Robometer-4B | 78.8% |
| RoboReward-8B | 81.4% |
| LLM-as-a-Verifier | 87.4% |
底层 verifier 是 Qwen 3.6 35B VLM,输入为两段机器人 rollout video。连续分数还把 RoboReward-8B 对人类 reward 标注的 MAE 从 1.11 降到 0.72。跨文本代码、视频机器人和医疗轨迹的结果,支持的是“同一种概率化读分方式可迁移”,不是“同一个 backbone 在所有领域都最强”。
连续分数还能表示任务进度吗¶
作者将 verifier 应用于每个 trajectory prefix,用 Value-Order Correlation(VOC)衡量分数是否随执行步骤单调上升。VOC 本质上是 step index 与 prefix score 的 Spearman rank correlation;越接近 1,越像一条稳定上升的进度曲线。
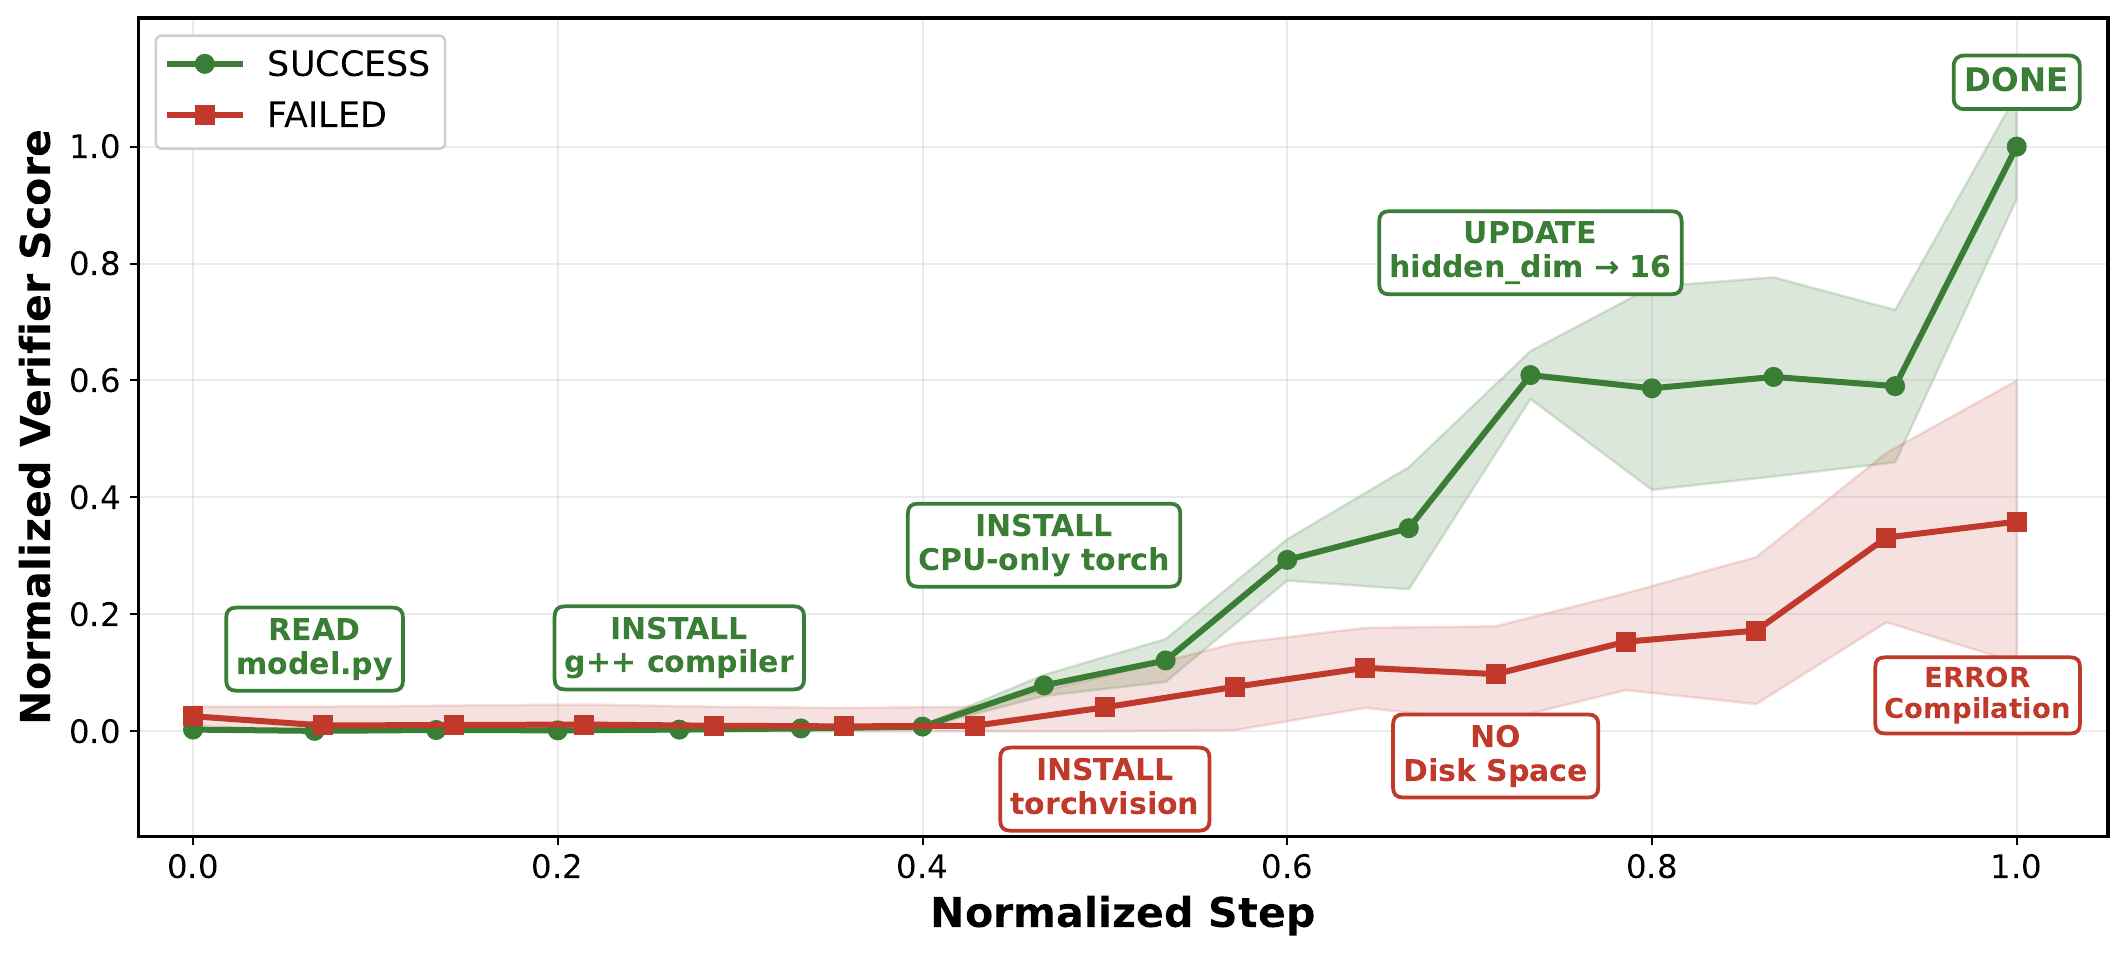
论文图 8。 成功轨迹从读取模型、安装编译器、安装 CPU torch、修改
hidden_dim到 DONE,分数明显上升;失败轨迹安装torchvision后耗尽磁盘并编译失败,分数长期较低。图展示的是单个可解释案例,不等同于总体分类准确率。
Terminal-Bench V2 的 500 条轨迹上,成功轨迹 VOC 为 0.848 ± 0.012,失败轨迹仍有 0.769 ± 0.016,差距只有 0.079。因此 VOC 更适合解释“是否在推进”,不能单独当作成功检测器:一条最终失败的轨迹也可能在前半段持续取得局部进展。
在 500 条 RoboReward 轨迹上,LLM-as-a-Verifier 的 VOC 为 0.966,高于 RoboReward-8B 的 0.877、Robometer-4B 的 0.780 和 TOPReward 的 0.565。
从论文方法到可用插件:TurboAgent¶
作者没有让这套方法停留在离线 benchmark 上,而是实现了 TurboAgent。论文引言将其称为面向 Claude Code 和 Codex 的 extensions;实验节给出的具体形态是一个可直接接入 Claude Code 和其他 OpenAI-API-compatible clients 的 inference-time proxy。
Claude Code / Codex / OpenAI-compatible client
  → TurboAgent 代理请求
  → 后端模型并行生成 N 个候选轨迹
  → LLM-as-a-Verifier 评分,PPT 选择最佳候选
  → 将最佳响应返回 client,并在 Web 界面展示 verifier 输出与实时进度
TurboAgent 位于 coding client 与 LLM provider 之间,不要求修改原有 agent harness 或后端模型,因此同样可以透明接入 Terminal-Bench 一类现有 benchmark。它把论文的两种能力同时落到了真实工作流里:一方面在每次请求上做 test-time candidate selection;另一方面向用户暴露 live verifier score,用于观察长任务是否仍在推进,并在破坏性状态写入磁盘前决定暂停或回滚。这里的工程实现很重要——论文提出的不只是一个新的离线评分指标,而是一层可以插入现有 coding-agent 调用链的运行时 verification middleware。
Dense reward 是重要扩展,但不是训练 verifier¶
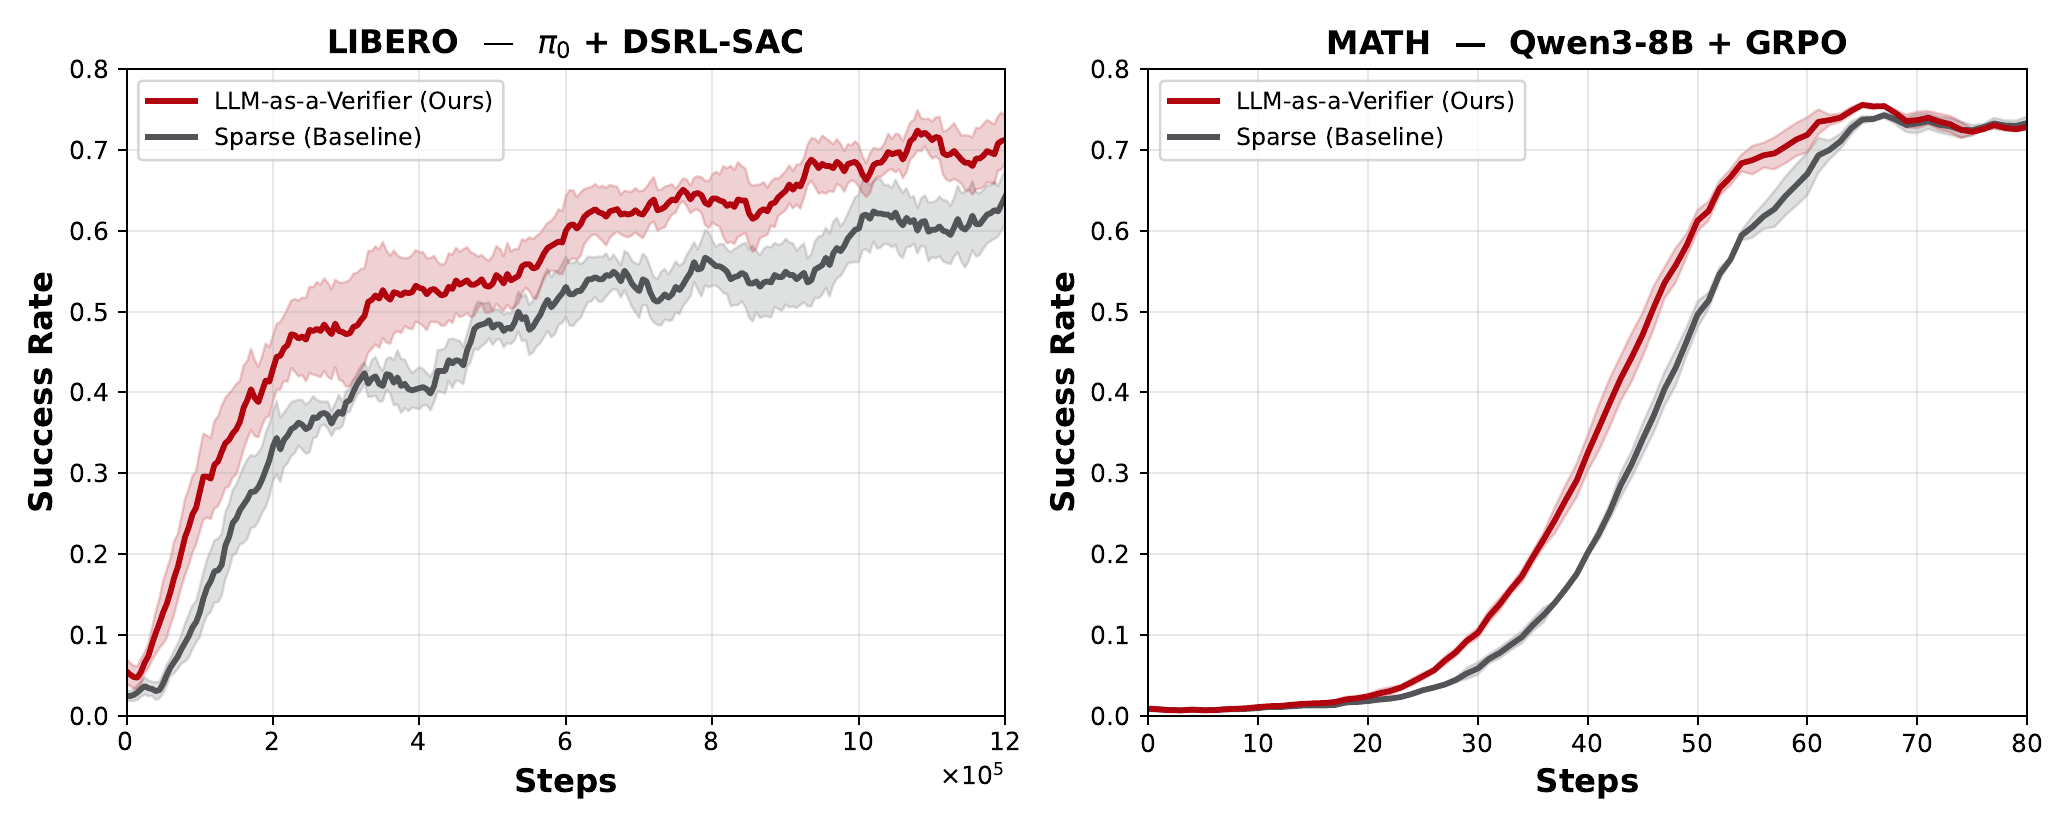
论文图 11。 左侧 LIBERO 的红线在大部分训练阶段领先 sparse baseline,最终成功率也更高;右侧 MATH 的主要收益是更早达到相同准确率,后期两条曲线接近。这与论文报告的 1.8 倍和约 1.1 倍 sample-efficiency gain 一致。
在 off-policy robotics RL 中,verifier 对 trajectory prefix 产生进度分 \(\rho_t\),再与环境奖励相加:
LIBERO + \(\pi_0\) + DSRL-SAC 在目标成功率 0.2-0.6 区间平均获得约 1.8 倍 sample efficiency,最终成功率为 0.76 vs 0.69。
在 MATH + Qwen3-8B + GRPO 中,早期一组回答可能全部错误,使 group-relative advantage 同为零。论文加入连续 reasoning reward:
让“都答错”的样本之间仍有相对质量差异,达到约 1.1 倍 sample efficiency。这里被训练的是 policy;LLM-as-a-Verifier 本身仍然冻结。因此把本文行内标签写成 reward model 会误导,Trajectory Scoring 更贴近核心。
我的判断与使用边界¶
这篇最有价值的地方,是把 verifier 的改进拆成了三个可以单独验证的工程旋钮,并证明同一个连续信号可以从 candidate selection 延伸到 progress tracking 和 RL。它不是简单宣称“让 LLM 多评几遍”,而是区分了:
- 评分粒度解决量化分辨率。
- 重复评价解决采样方差。
- criteria decomposition 解决复合 rubric 的偏置和认知负担。
- PPT 解决 verifier compute 的分配效率。
但它离“通用可靠验证器”仍有明显距离:
- 依赖 scoring-token logits。 很多闭源 API 不返回 logprobs。附录的两阶段方案让闭源模型先生成 reasoning、再交给可读 logits 的模型评分,能恢复大部分收益,但增加延迟、成本和新的模型耦合。
- 连续不等于确定。 它消除 tie、改善 calibration,却仍是概率性 LLM judgment;
query-optimize中 \(G=20\) 仍有 23% 反向排序。 - criteria 依赖人工设计。 三项拆分在 coding 中有效,迁移到医疗或机器人时仍需要领域判断,论文没有证明自动 decomposition。
- 收益受候选池限制。 Ours 始终低于 Oracle;如果 proposal policy 没生成正确轨迹,再强的 selector 也无能为力。
- RL 证据仍是早期结果。 论文只验证 single-turn robotics 和 math RL,没有解决长时程 multi-turn agent 中跨动作的真实 credit assignment,也没有系统研究 verifier reward hacking。
- Progress score 不能替代终局判断。 成功/失败轨迹 VOC 都很高,live score 更适合做监控信号,而不是独立安全门。
最终可以把本文准确地概括为:它没有训练一个更懂某领域的 reward model,而是从冻结 LLM/VLM 已有的评分分布中提取更细的轨迹价值,再通过结构化增加 verification compute,让这个价值信号更适合排序、监控和奖励塑形;TurboAgent 则进一步把这套方法实现为可插入现有 coding-agent 调用链的运行时代理。